爬虫实战四、PyCharm+Scrapy爬取数据并存入MySQL
注意:此博客衔接爬虫实战三、PyCharm搭建Scrapy开发调试环境,参考此博客之前请详细阅读爬虫实战三、PyCharm搭建Scrapy开发调试环境
#一、创建爬虫项目
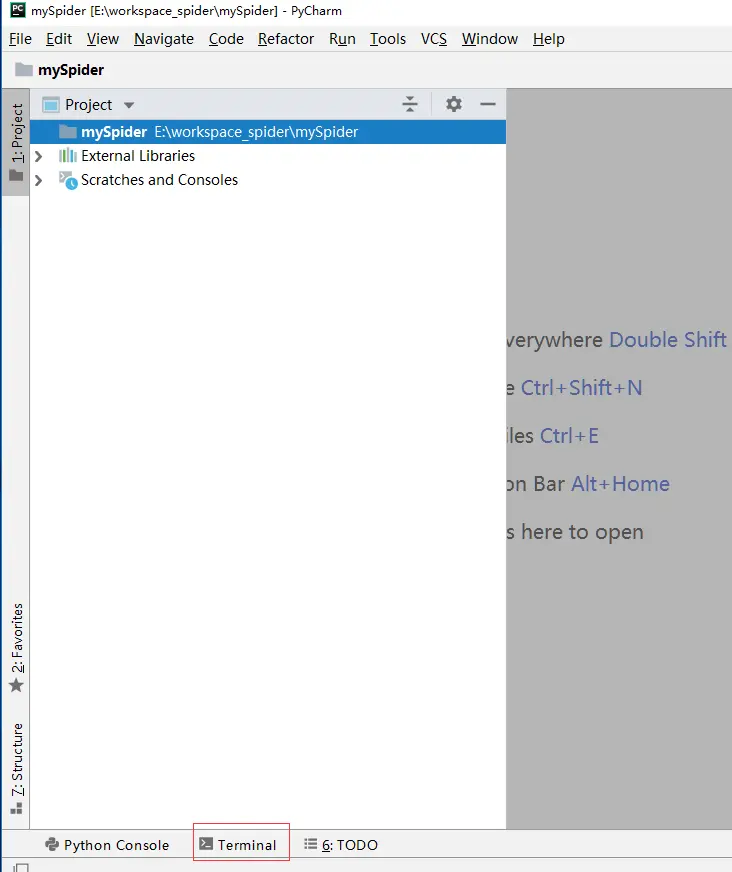
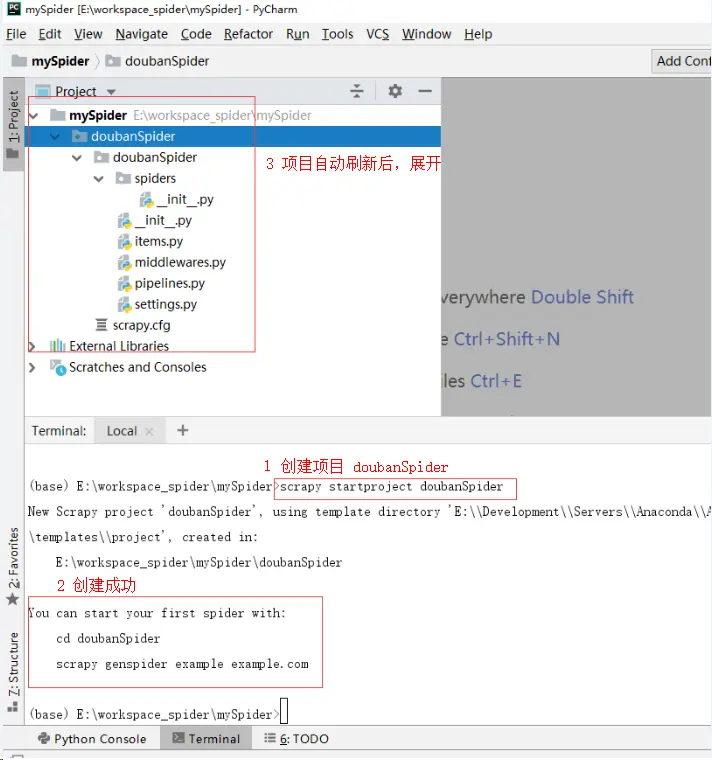
注意:不能直接使用PyCharm创建Scrapy项目,所以需要在爬虫实战三、PyCharm搭建Scrapy开发调试环境的基础(PyCharm配置完Scrapy)之上,选中mySpider项目,点击PyCharm中下方的Terminal,进入对应的命令行,执行命令创建doubanSpider项目
scrapy startproject doubanSpider 进入命令行。
创建项目。
#二、创建爬虫并编写代码
爬虫项目生成后,进入项目路径。
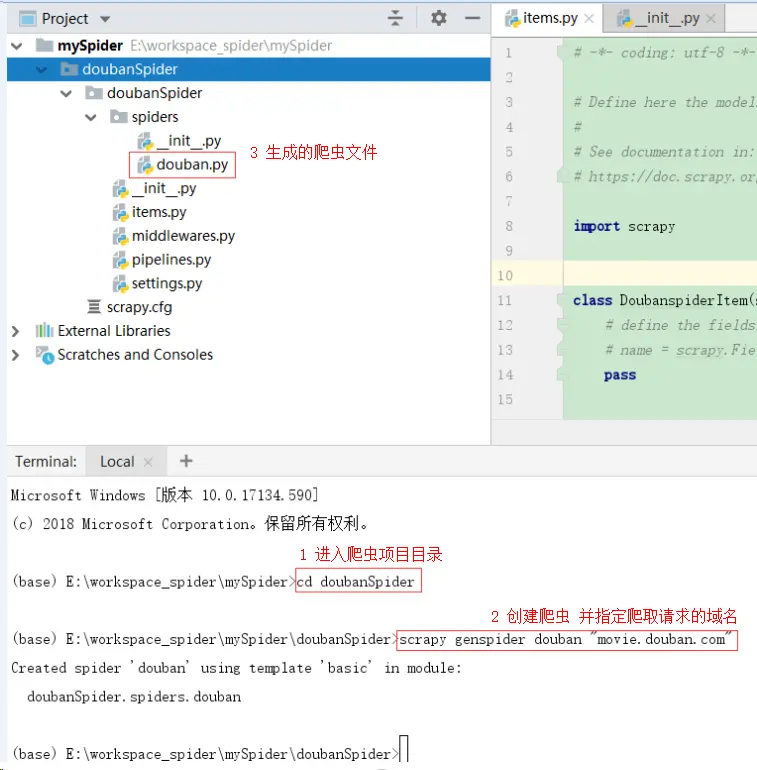
执行命令创建douban爬虫
scrapy genspider douban "movie.douban.com" ###2-1、编写items.py
# -*- coding: utf-8 -*- # Define here the models for your scraped items # # See documentation in: # https://doc.scrapy.org/en/latest/topics/items.html import scrapy class DoubanspiderItem(scrapy.Item): # 电影标题 title = scrapy.Field() # 电影信息 info = scrapy.Field() # 电影评分 score = scrapy.Field() # 评分人数 number = scrapy.Field() # 简介 content = scrapy.Field() ###2-2、编写spiders/douban.py
# -*- coding: utf-8 -*- import scrapy from doubanSpider.items import DoubanspiderItem class DoubanSpider(scrapy.Spider): name = "douban" allowed_domains = ["movie.douban.com"] start = 0 url = 'https://movie.douban.com/top250?start=' end = '&filter=' start_urls = [url + str(start) + end] def parse(self, response): item = DoubanspiderItem() movies = response.xpath("//div[@class=\'info\']") for movie in movies: name = movie.xpath('div[@class="hd"]/a/span/text()').extract() message = movie.xpath('div[@class="bd"]/p/text()').extract() star = movie.xpath('div[@class="bd"]/div[@class="star"]/span[@class="rating_num"]/text()').extract() number = movie.xpath('div[@class="bd"]/div[@class="star"]/span/text()').extract() quote = movie.xpath('div[@class="bd"]/p[@class="quote"]/span/text()').extract() if quote: quote = quote[0] else: quote = '' item['title'] = ''.join(name) item['info'] = quote item['score'] = star[0] item['content'] = ';'.join(message).replace(' ', '').replace('\n', '') item['number'] = number[1].split('人')[0] # 提交item yield item if self.start <= 225: self.start += 25 yield scrapy.Request(self.url + str(self.start) + self.end, callback=self.parse) ###2-3、编写pipelines.py
# -*- coding: utf-8 -*- # Define your item pipelines here # # Don't forget to add your pipeline to the ITEM_PIPELINES setting # See: https://doc.scrapy.org/en/latest/topics/item-pipeline.html from pymysql import cursors from twisted.enterprise import adbapi import time import copy class DoubanspiderPipeline(object): # 初始化函数 def __init__(self, db_pool): self.db_pool = db_pool # 从settings配置文件中读取参数 @classmethod def from_settings(cls, settings): # 用一个db_params接收连接数据库的参数 db_params = dict( host=settings['MYSQL_HOST'], user=settings['MYSQL_USER'], password=settings['MYSQL_PASSWORD'], port=settings['MYSQL_PORT'], database=settings['MYSQL_DBNAME'], charset=settings['MYSQL_CHARSET'], use_unicode=True, # 设置游标类型 cursorclass=cursors.DictCursor ) # 创建连接池 db_pool = adbapi.ConnectionPool('pymysql', **db_params) # 返回一个pipeline对象 return cls(db_pool) # 处理item函数 def process_item(self, item, spider): # 对象拷贝,深拷贝 --- 这里是解决数据重复问题!!! asynItem = copy.deepcopy(item) # 把要执行的sql放入连接池 query = self.db_pool.runInteraction(self.insert_into, asynItem) # 如果sql执行发送错误,自动回调addErrBack()函数 query.addErrback(self.handle_error, item, spider) # 返回Item return item # 处理sql函数 def insert_into(self, cursor, item): # 创建sql语句 sql = "INSERT INTO movie (title,info,score,number,content,createtime) VALUES ('{}','{}','{}','{}','{}','{}')".format( item['title'], item['info'], item['score'], item['number'], item['content'], time.strftime("%Y-%m-%d %H:%M:%S", time.localtime())) # 执行sql语句 cursor.execute(sql) # 错误函数 def handle_error(self, failure, item, spider): # #输出错误信息 print("failure", failure) ###2-4、编写settings.py
# -*- coding: utf-8 -*- BOT_NAME = 'doubanSpider' SPIDER_MODULES = ['doubanSpider.spiders'] NEWSPIDER_MODULE = 'doubanSpider.spiders' # Obey robots.txt rules ROBOTSTXT_OBEY = True USER_AGENT = 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_11_3) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/48.0.2564.116 Safari/537.36' # Configure item pipelines # See https://doc.scrapy.org/en/latest/topics/item-pipeline.html ITEM_PIPELINES = { 'doubanSpider.pipelines.DoubanspiderPipeline': 300 } # 连接数据MySQL # 数据库地址 MYSQL_HOST = 'localhost' # 数据库用户名: MYSQL_USER = 'root' # 数据库密码 MYSQL_PASSWORD = 'root' # 数据库端口 MYSQL_PORT = 3306 # 数据库名称 MYSQL_DBNAME = 'mydb' # 数据库编码 MYSQL_CHARSET = 'utf8' ###在创建爬虫并编写代码时遇到的坑
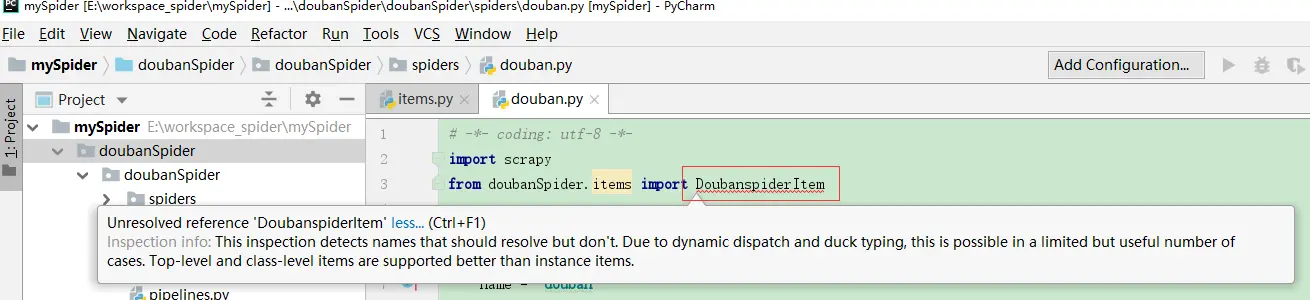
#####坑1、Unresolved reference ‘xxx’ 或者显示 scrapy No module named ×××.items
#####坑1、解决办法
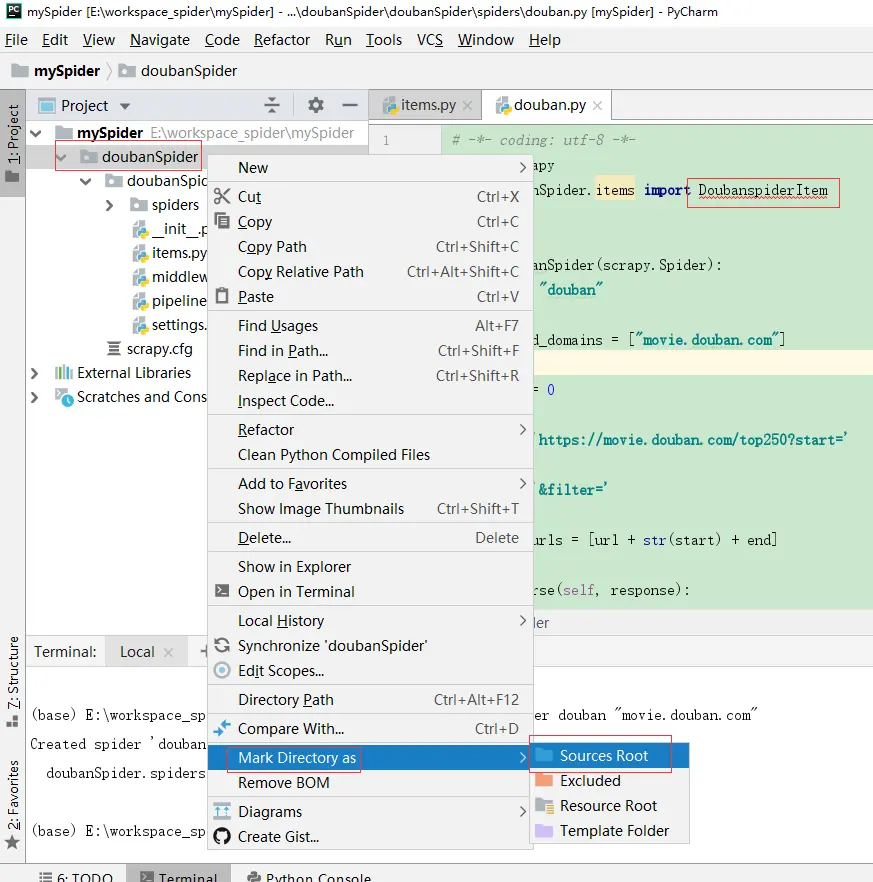
将爬虫项目的文件夹类型改为Sources Root
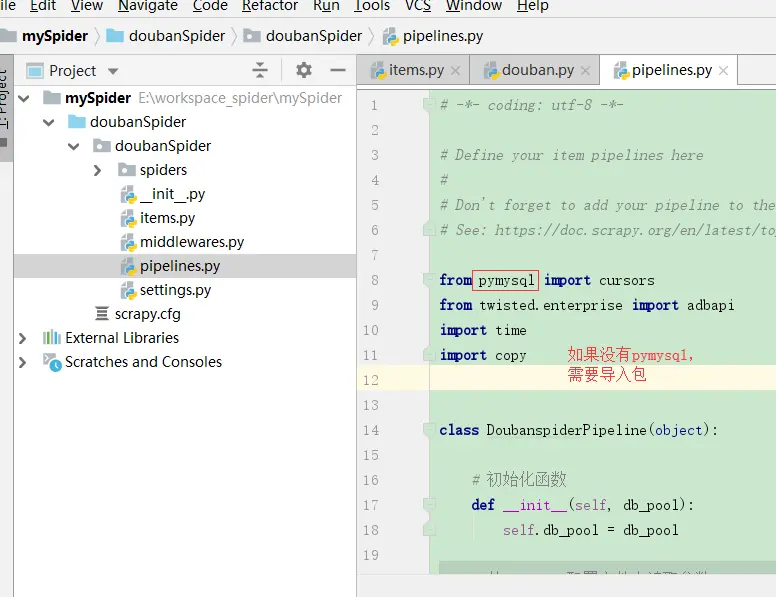
#####坑2、连接MySQL时缺少pymysql
#####坑2、解决办法
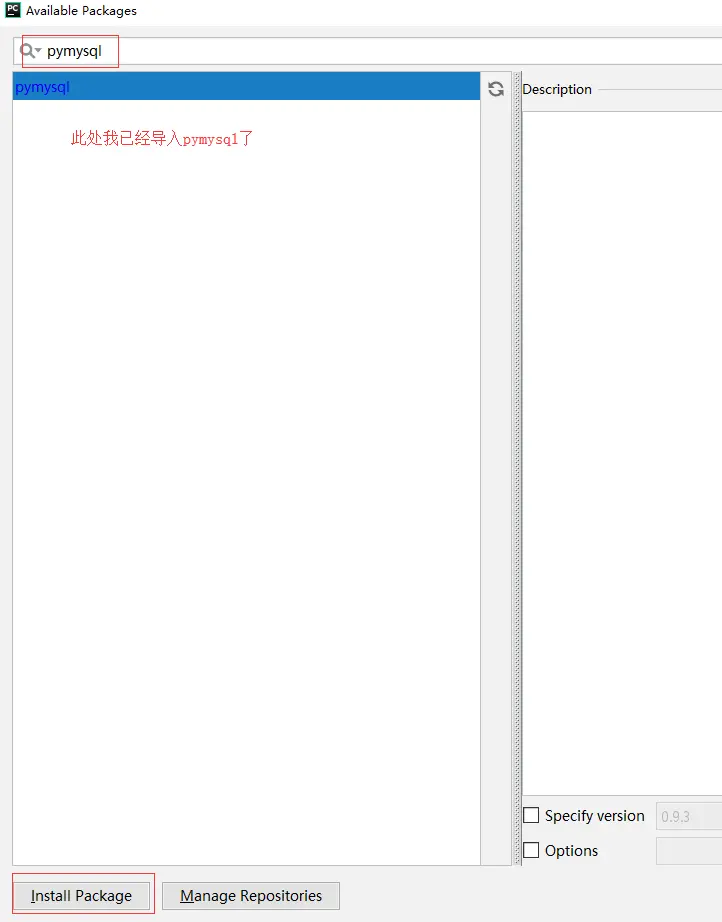
点击File-> Settings->Project: mySpider->Project Interpreter,导入pymysql包。具体添加包的流程参考爬虫实战三、PyCharm搭建Scrapy开发调试环境。
#三、使用Pycharm连接MySQL数据库
连接MySQL的工具有很多,Pycharm本身也可以连接MySQL和其他多种数据库,并且提示功能比较强大,这里我使用Pycharm连接MySQL数据库。
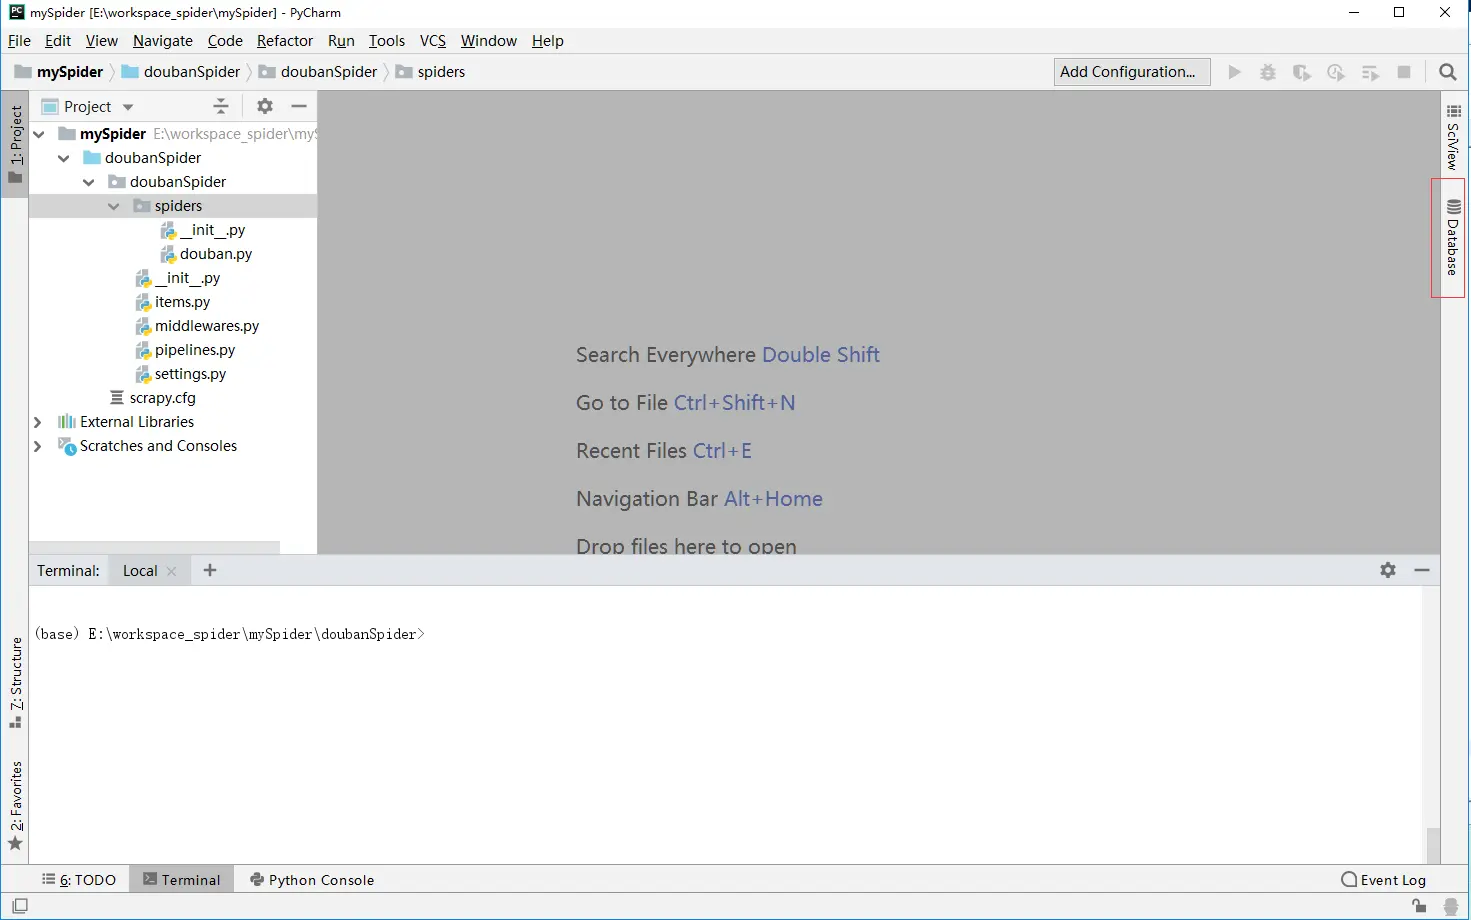
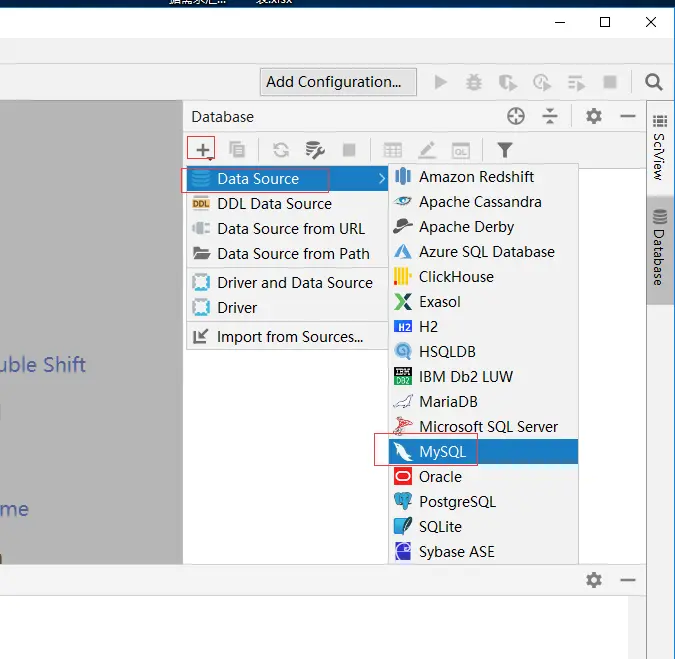
选择数据库类型,MySQL
设置连接别名,主机,数据库,用户名,密码。
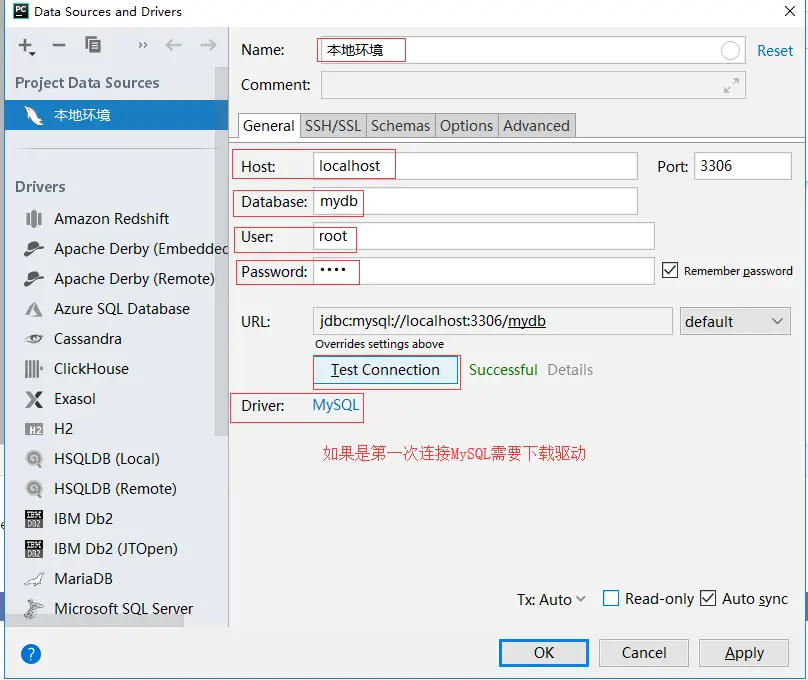
设置完毕,连接MySQL。
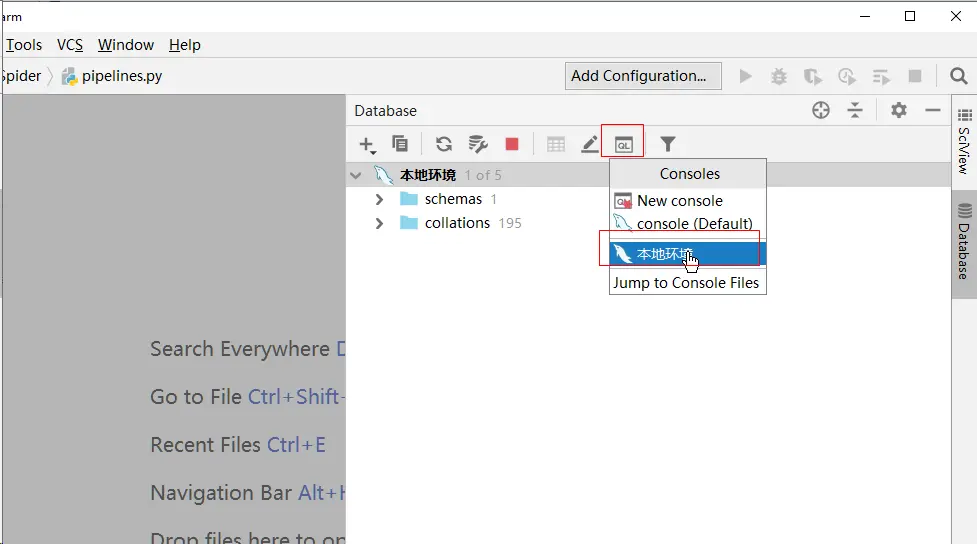
#四、创建爬虫项目对应的表以及执行爬虫。
###4-1、创建表
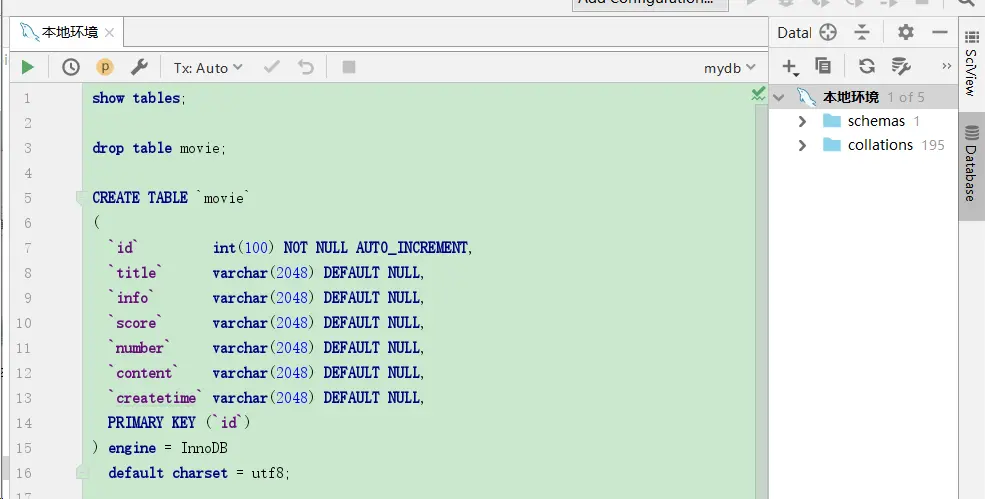
创建movie表,注意 default charset = utf8 此处要和爬虫程序编码一致,否则存入到MySQL失败。
drop table movie; CREATE TABLE `movie` ( `id` int(100) NOT NULL AUTO_INCREMENT, `title` varchar(2048) DEFAULT NULL, `info` varchar(2048) DEFAULT NULL, `score` varchar(2048) DEFAULT NULL, `number` varchar(2048) DEFAULT NULL, `content` varchar(2048) DEFAULT NULL, `createtime` varchar(2048) DEFAULT NULL, PRIMARY KEY (`id`) ) engine = InnoDB default charset = utf8; ###4-2、执行爬虫
在爬虫项目对应的命令行中执行命令,运行爬虫
scrapy crawl douban 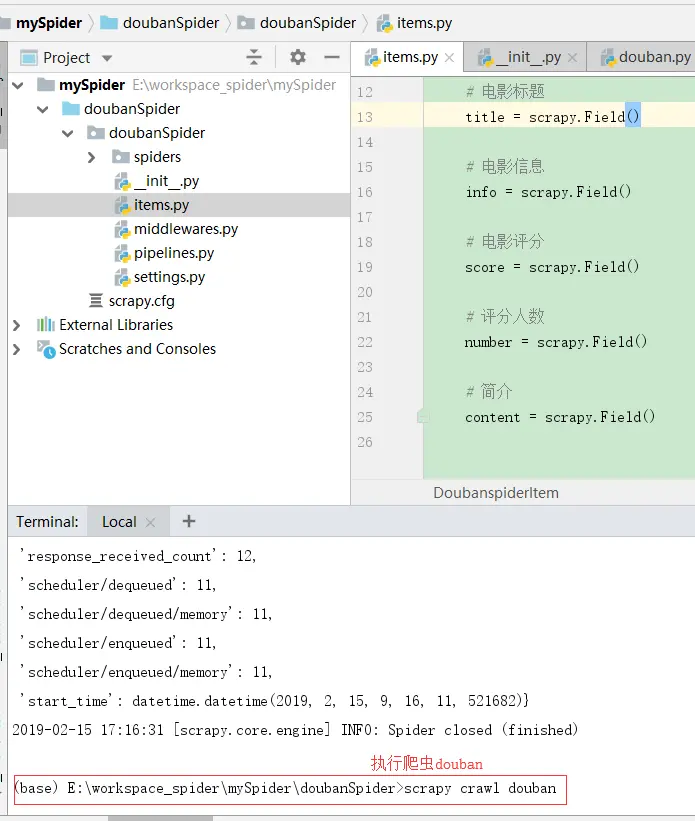
###4-3、查询数据,验证结果
在本地连接中执行SQL:
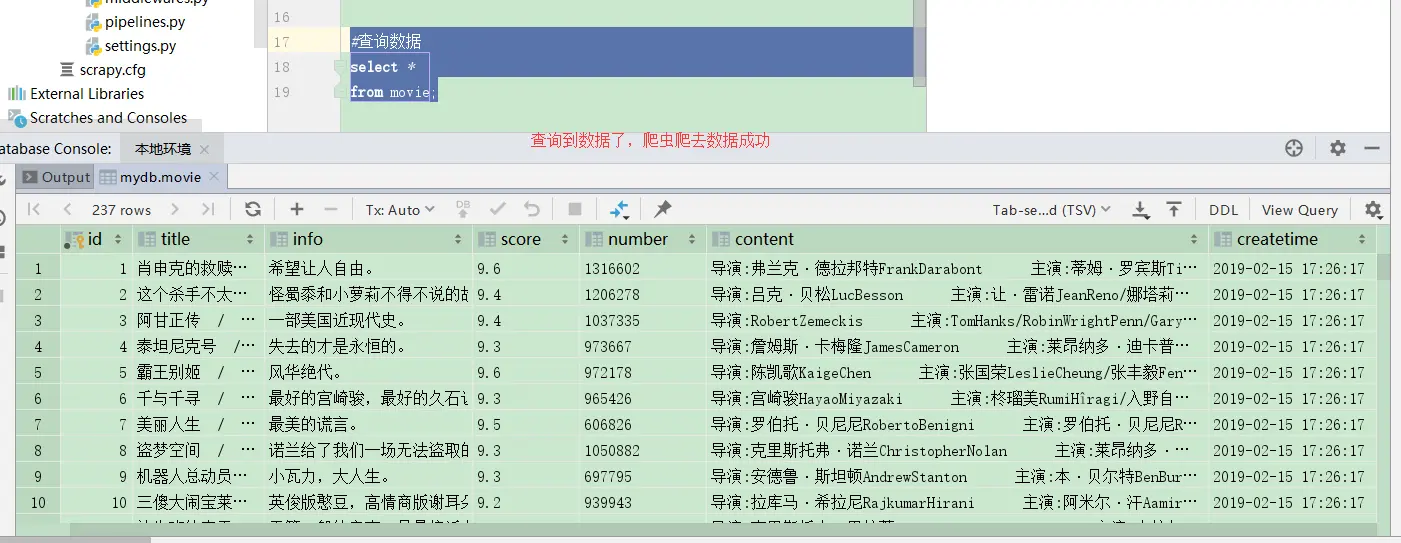
select * from movie; 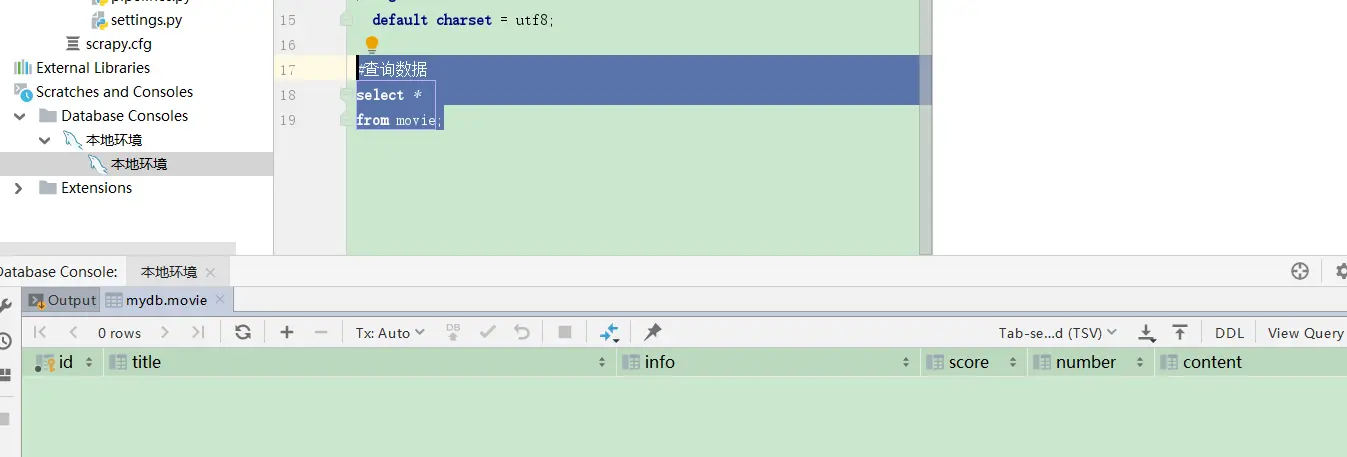
爬虫数据并存入MySQL成功。注意,网上有部分博客实践后出现数据重复问题,此处我已经修改过代码保证数据不重复。