

基于LLaMA-Factory的微调记录
LLaMA Factory 是一个易于使用的大规模语言模型微调框架。它具有以下特点:
- 支持多种模型:包括 LLaMA、BLOOM、Mistral、Baichuan、Qwen、ChatGLM、Phi 等。
- 集成多种方法:涵盖(增量)预训练、指令监督微调、奖励模型训练、PPO 训练、DPO 训练和 ORPO 训练等集成方法;支持 32 比特全参数微调、16 比特冻结微调、16 比特 LoRA 微调和基于 AQLM/AWQ/GPTQ/LLM.int8 的 2/4/8 比特 QLoRA 微调等多种精度;包含 GaLore、DoRA、LongLoRA、LLaMAPro、LoRA+、LoftQ 和 Agent 微调等先进算法;具备 FlashAttention-2、Unsloth、RoPEscaling、NEFTune 和 rsLoRA 等实用技巧;提供 LlamaBoard、TensorBoard、Wandb、MLflow 等实验监控;支持基于 vLLM 的 OpenAI 风格 API、浏览器界面和命令行接口的极速推理。
- 提供 WebUI 页面:方便非开发人员进行微调工作。
其部署安装相对简单,步骤如下:
- 克隆仓库:
git clone https://github.com/hiyouga/LLaMA-Factory.git - 创建虚拟环境:
conda create -n llama_factory python=3.10 - 激活虚拟环境:
conda activate llama_factory - 安装依赖:
cd LLaMA-Factory,然后执行pip install -r requirements.txt
接下来可以下载所需的 LLM 模型,例如 BaiChuan 模型,注意如果使用 BaiChuan 模型,需要修改 transformers 的版本为 4.33.2,否则可能会报AttributeError: 'BaichuanTokenizer' object has no attribute 'p_model'的错误。
在使用 LLaMA Factory 进行微调时,需要指定训练方式(如预训练、指令监督微调等)、选择微调策略(如 LoRA 或 QLoRA),并准备相应的数据集。它提供了命令行接口或 WebUI 来进行具体的操作和监控微调过程。
如果你想了解更多关于 LLaMA Factory 的详细信息,例如如何加载训练数据、模型评估能力等,可以参考其项目的 GitHub 页面(https://github.com/hiyouga/LLaMA-Factory )及相关文档。
LLaMA-Factory是一个非常好用的无代码微调框架,不管是在模型、微调方式还是参数设置上都提供了非常完备的支持,下面是对微调全过程的一个记录。
数据模型准备
微调时一般需要准备三个数据集:一个是自我认知数据集(让大模型知道自己是谁),一个是特定任务数据集(微调时需要完成的目标任务),一个是通用任务数据集(保持大模型的通用能力,防止变傻)。前两个一般要自己定义,最后一个用现成的就行。
自定义数据集可采用alpaca和sharegpt格式,这里采用的是alpaca格式:
[ { "instruction": "用户指令(必填)", "input": "用户输入(选填)", "output": "模型回答(必填)", "system": "系统提示词(选填)", "history": [ ["第一轮指令(选填)", "第一轮回答(选填)"], ["第二轮指令(选填)", "第二轮回答(选填)"] ] } ] 由于不需要考虑多轮对话,所以history可以不要,这里采用了两种数据集的组织方式,一种是只有instruction和output,把问题作为instruction,另外一种是把问题作为input,把回答问题这一要求作为instruction。这两种格式分别记为format2和format3。
在根据若干个不同的专业领域生成完多个自定义的问答json文件之后,分别生成其format2和format3的文件以及test测试文件,根据以下代码计算其sha1值:
import hashlib def calculate_sha1(file_path): sha1 = hashlib.sha1() try: with open(file_path, 'rb') as file: while True: data = file.read(8192) # Read in chunks to handle large files if not data: break sha1.update(data) return sha1.hexdigest() except FileNotFoundError: return "File not found." # 使用示例 file_path = './data/self_cognition_modified.json' # 替换为您的文件路径 sha1_hash = calculate_sha1(file_path) print("SHA-1 Hash:", sha1_hash) 将这些json文件放入data文件夹下,同步修改dataset_info.json文件,输入新增的文件名称和对应的sha1值。
测试的大模型可以使用这些,注意要下载最新版,老版的模型结构不太匹配。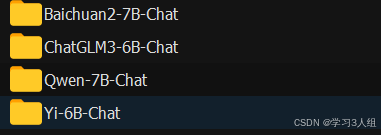
基于网页的简单微调
在后台执行CUDA_VISIBLE_DEVICES=0 python src/train_web.py命令,成功开启网页,设置如下,手动输入模型路径。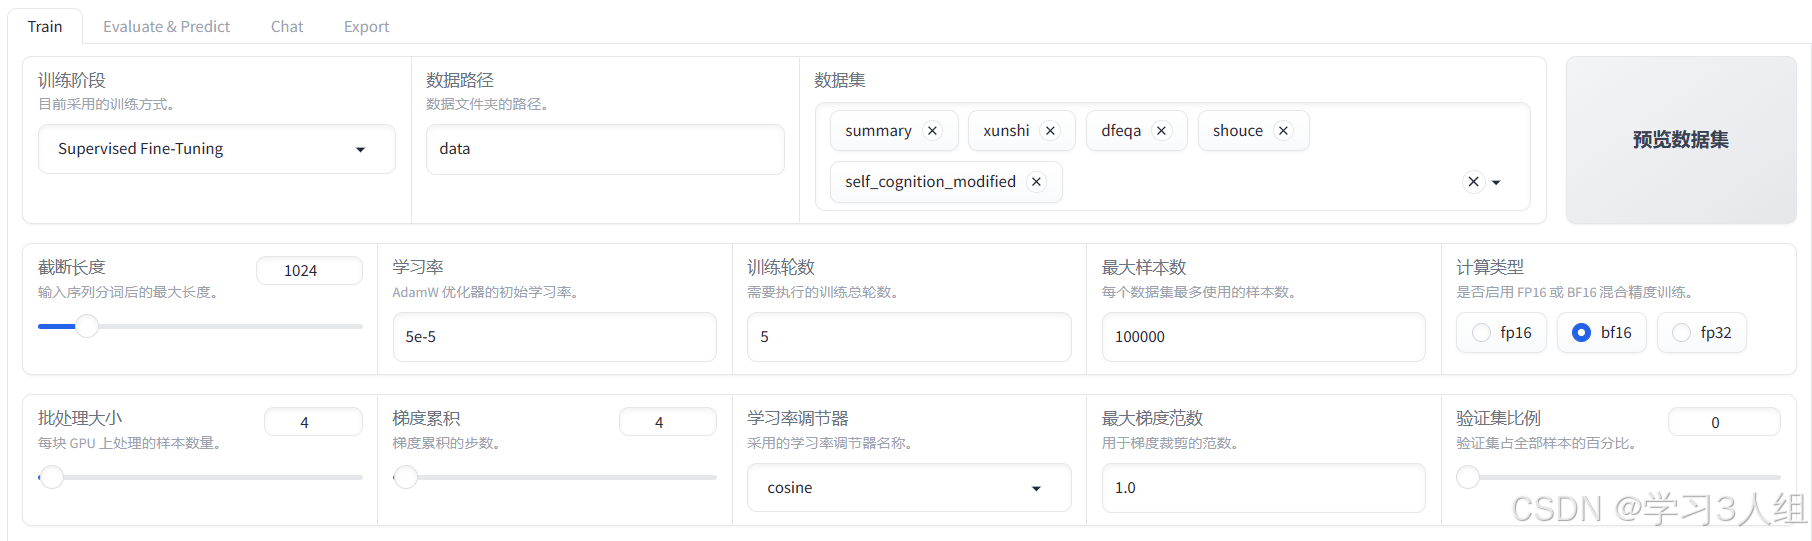
训练完成之后的界面,可以查看损失函数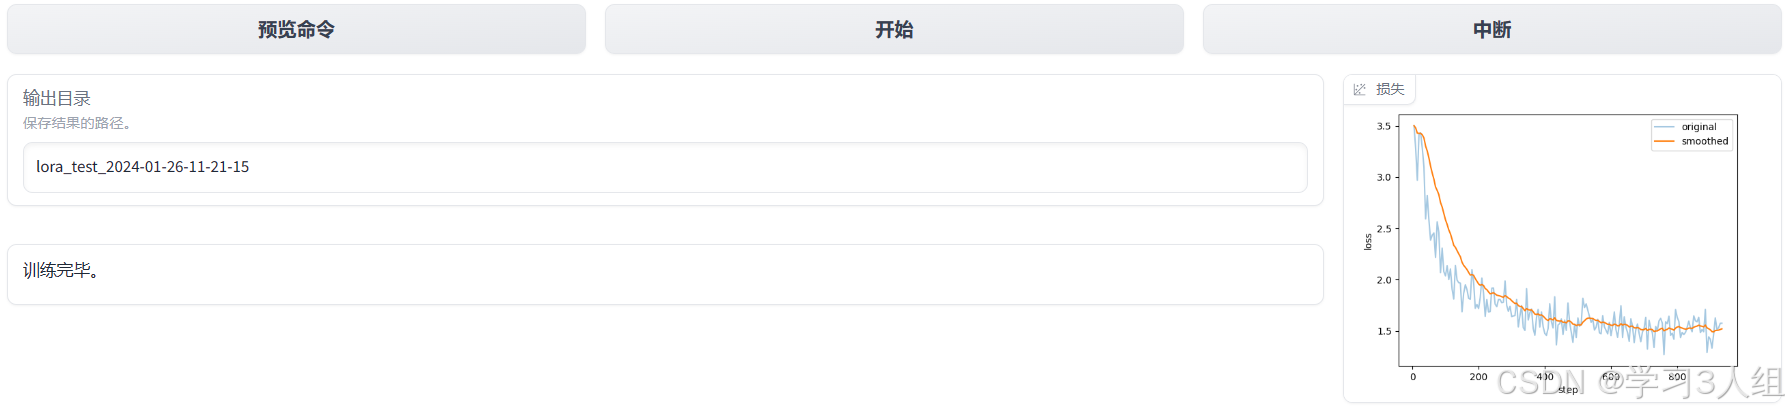
基于网页的简单评测
原始模型评测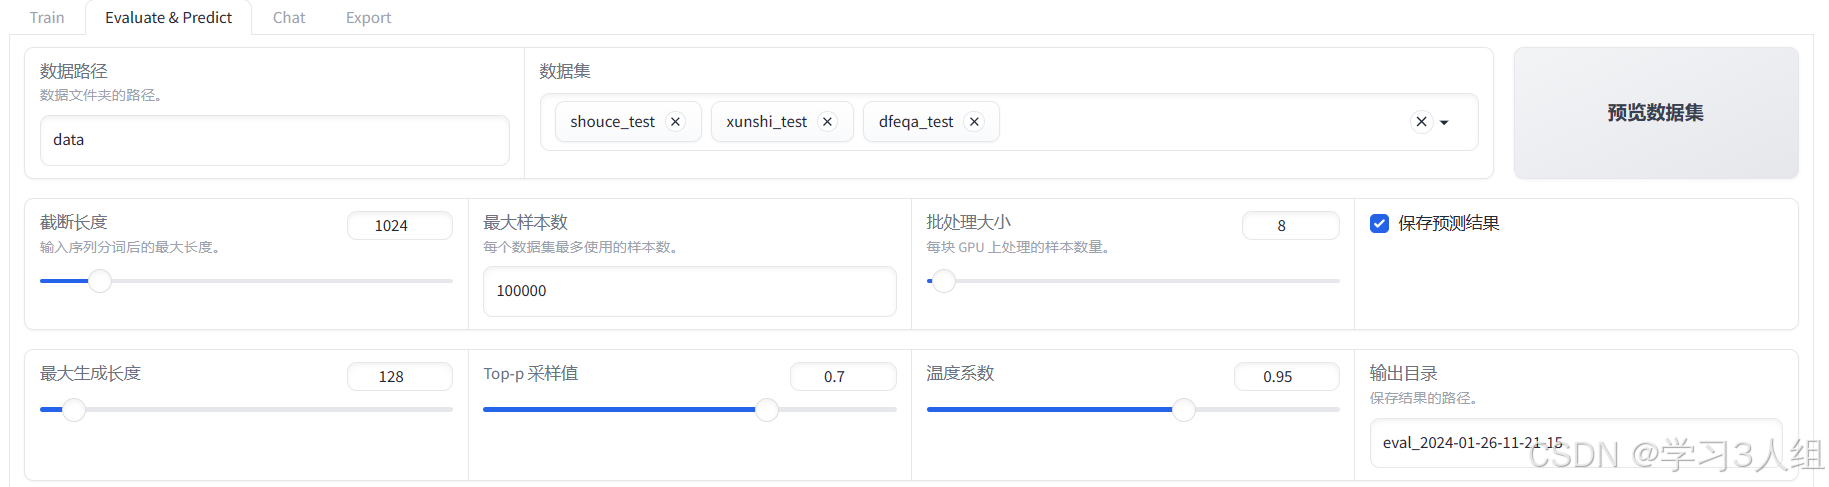
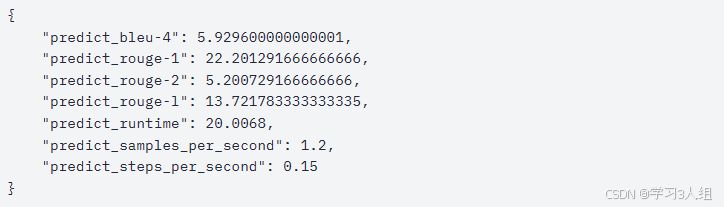
微调后模型评测
首先加载lora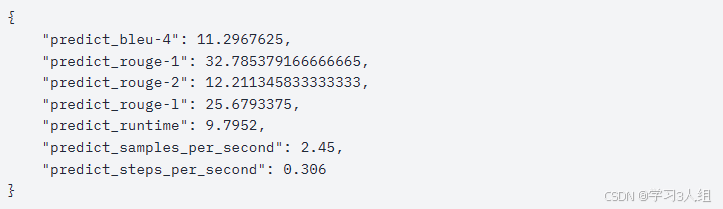
可以看到,微调之后的模型在各个指标上有了显著提升
基于网页的简单聊天
切换到Chat并点击加载模型后,可以进入聊天
文章来源: https://gitcode.csdn.net/66274faca2b051225565dba8.html