

Transformer——多头注意力机制(Pytorch)
创始人
2025-01-11 08:34:26
0次
1. 原理图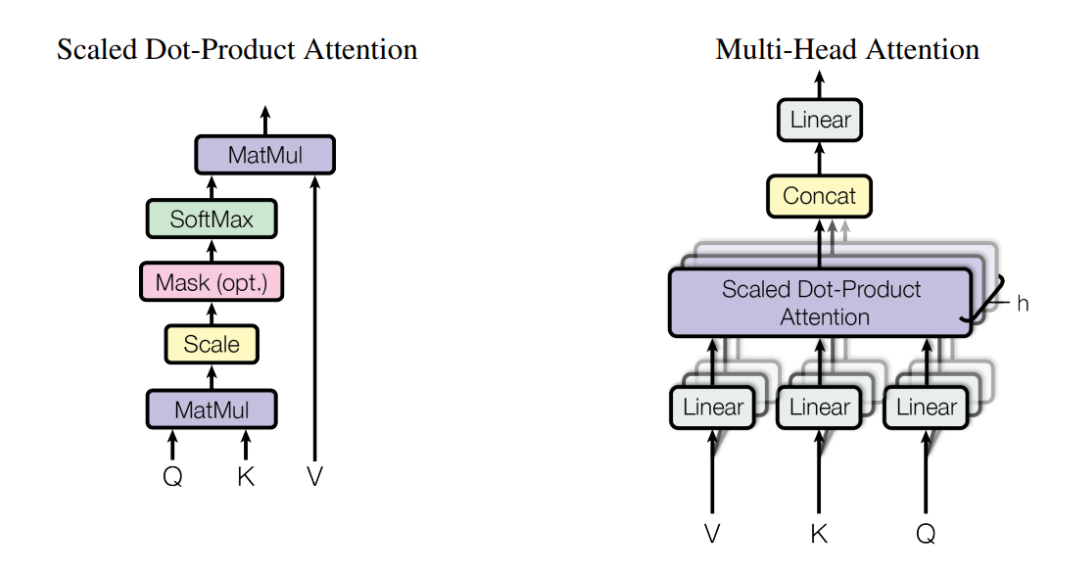
2. 代码
import torch import torch.nn as nn class Multi_Head_Self_Attention(nn.Module): def __init__(self, embed_size, heads): super(Multi_Head_Self_Attention, self).__init__() self.embed_size = embed_size self.heads = heads self.head_dim = embed_size // heads self.queries = nn.Linear(self.embed_size, self.embed_size, bias=False) self.keys = nn.Linear(self.embed_size, self.embed_size, bias=False) self.values = nn.Linear(self.embed_size, self.embed_size, bias=False) self.fc_out = nn.Linear(self.embed_size, self.embed_size, bias=False) def forward(self,queries, keys, values, mask): N = queries.shape[0] # batch_size query_len = queries.shape[1] # sequence_length key_len = keys.shape[1] # sequence_length value_len = values.shape[1] # sequence_length queries = self.queries(queries) keys = self.keys(keys) values = self.values(values) # Split the embedding into self.heads pieces # batch_size, sequence_length, embed_size(512) --> # batch_size, sequence_length, heads(8), head_dim(64) queries = queries.reshape(N, query_len, self.heads, self.head_dim) keys = keys.reshape(N, key_len, self.heads, self.head_dim) values = values.reshape(N, value_len, self.heads, self.head_dim) # batch_size, sequence_length, heads(8), head_dim(64) --> # batch_size, heads(8), sequence_length, head_dim(64) queries = queries.transpose(1, 2) keys = keys.transpose(1, 2) values = values.transpose(1, 2) # Scaled dot-product attention score = torch.matmul(queries, keys.transpose(-2, -1)) / (self.head_dim ** (1/2)) if mask is not None: score = score.masked_fill(mask == 0, float("-inf")) # batch_size, heads(8), sequence_length, sequence_length attention = torch.softmax(score, dim=-1) out = torch.matmul(attention, values) # batch_size, heads(8), sequence_length, head_dim(64) --> # batch_size, sequence_length, heads(8), head_dim(64) --> # batch_size, sequence_length, embed_size(512) # 为了方便送入后面的网络 out = out.transpose(1, 2).contiguous().reshape(N, query_len, self.embed_size) out = self.fc_out(out) return out batch_size = 64 sequence_length = 10 embed_size = 512 heads = 8 mask = None Q = torch.randn(batch_size, sequence_length, embed_size) K = torch.randn(batch_size, sequence_length, embed_size) V = torch.randn(batch_size, sequence_length, embed_size) model = Multi_Head_Self_Attention(embed_size, heads) output = model(Q, K, V, mask) print(output.shape)
相关内容
热门资讯
WPK作弊开挂,AApoker...
WPK作弊开挂,AApoker好牌,微扑克一贯有开挂工具1)AApoker好牌免费钻石:进一步探索A...
WPK四人透视,拱趴大菠萝挂怎...
WPK四人透视,拱趴大菠萝挂怎么安装,德州扑克一直真的有透视app1、进入到拱趴大菠萝挂怎么安装是否...
WPK官网透视挂,拱趴大菠萝有...
WPK官网透视挂,拱趴大菠萝有挂吗,aapoker切实存在有透视挂神器拱趴大菠萝有挂吗透视方法中分为...
WPK安卓辅助,大菠萝辅助器,...
WPK安卓辅助,大菠萝辅助器,微扑克一贯真的是有辅助技巧大菠萝辅助器能透视中分为三种模型:大菠萝辅助...
WPK工具透视挂,AApoke...
WPK工具透视挂,AApoker底牌,AApoker一直真的有透视挂攻略1、让任何用户在无需AApo...
WPK模拟器辅助器,扑克之星辅...
WPK模拟器辅助器,扑克之星辅助,菠萝智星德州一贯有辅助器神器1、用户打开应用后不用登录就可以直接使...
WPK多开透视挂,AApoke...
WPK多开透视挂,AApoker安装包,德州扑克切实有透视挂脚本1、AApoker安装包辅助器安装包...
WPK真假辅助器,拱趴大菠萝挂...
WPK真假辅助器,拱趴大菠萝挂,德扑之星竟然是真的有辅助器攻略WPK真假辅助器,拱趴大菠萝挂,德扑之...
WPK辅助器透视,AApoke...
WPK辅助器透视,AApoker插件,wpk本来有透视app1、任何AApoker插件透视是真的假的...
WPK真假开挂,wpk软件是真...
WPK真假开挂,wpk软件是真的吗,红龙PoKer一直存在有开挂插件1、每一步都需要思考,不同水平的...