

Transformer模型:Decoder的self-attention mask实现
创始人
2025-01-08 16:06:28
0次
前言
这是对Transformer模型Word Embedding、Postion Embedding、Encoder self-attention mask、intra-attention mask内容的续篇。
视频链接:20、Transformer模型Decoder原理精讲及其PyTorch逐行实现_哔哩哔哩_bilibili
文章链接:Transformer模型:WordEmbedding实现-CSDN博客
Transformer模型:Postion Embedding实现-CSDN博客
Transformer模型:Encoder的self-attention mask实现-CSDN博客
Transformer模型:intra-attention mask实现-CSDN博客
正文
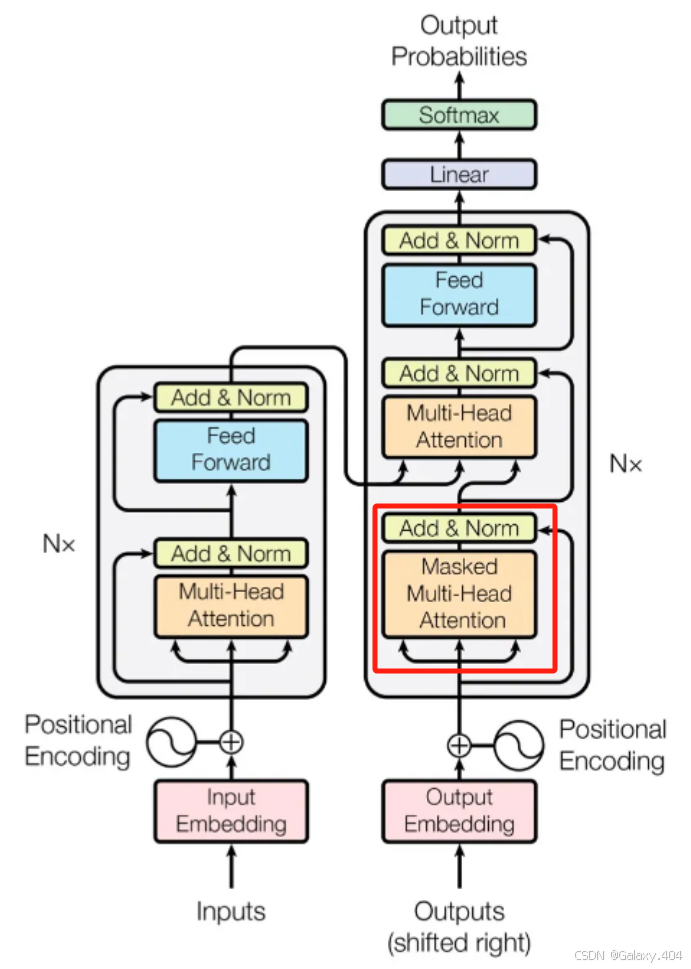
首先介绍一下Deoder的self-attention mask,它与前面的两个mask不一样地方在于Decoder是生成一个单词之后,将改单词作为输入给到Decoder中继续生成下一个,也就是相当于下三角矩阵,一次多一个,直到完成整个预测。
先生成一个下三角矩阵:
tri_matrix = [torch.tril(torch.ones(L, L)) for L in tgt_len]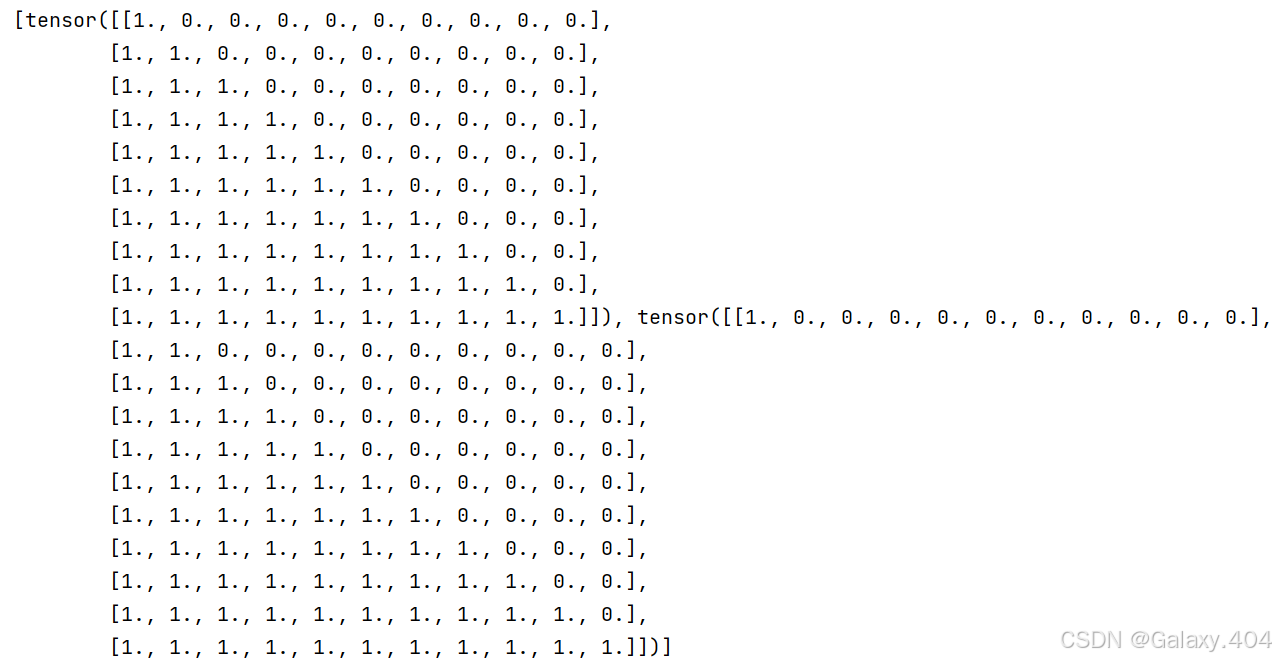
这里生成的两个下三角矩阵的维度是不一样的,首先要统一维度:
valid_decoder_tri_matrix = [F.pad(torch.tril(torch.ones(L, L)), (0, max_tgt_seg_len-L, 0, max_tgt_seg_len-L)) for L in tgt_len]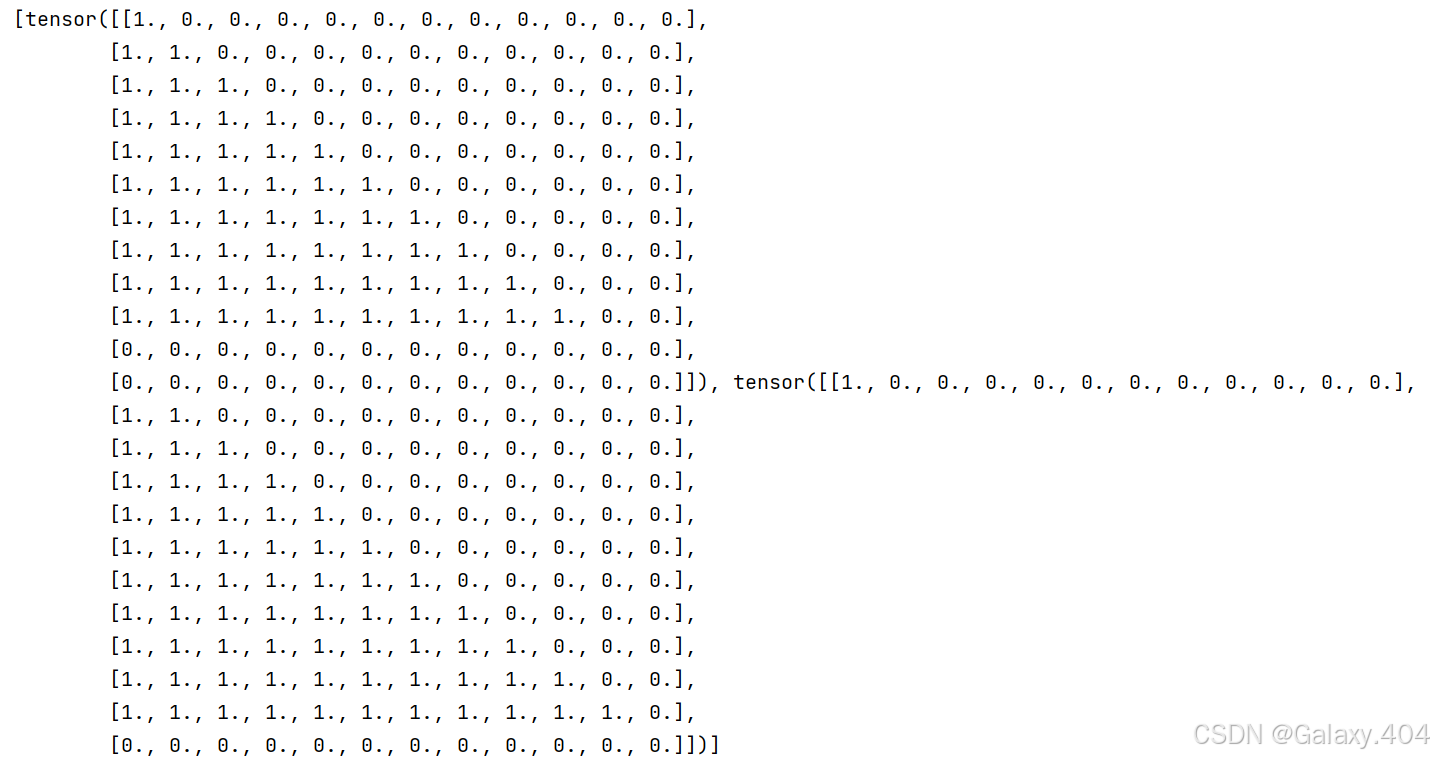
然后就是将它转为1个3维的张量形式,过程跟先前类似,这里就不一步步拆解了:
valid_decoder_tri_matrix = torch.cat([torch.unsqueeze(F.pad(torch.tril(torch.ones(L, L)), (0, max_tgt_seg_len-L, 0, max_tgt_seg_len-L)),0) for L in tgt_len]) 后续掩码过程还是跟前两篇一样,这里也不多解释了:
invalid_decoder_tri_matrix = 1 - valid_decoder_tri_matrix mask_decoder_self_attention = invalid_decoder_tri_matrix.to(torch.bool) score2 = torch.randn(batch_size, max_tgt_seg_len, max_tgt_seg_len) mask_score3 = score2.masked_fill(mask_decoder_self_attention, -1e9) prob3 = F.softmax(mask_score3, -1)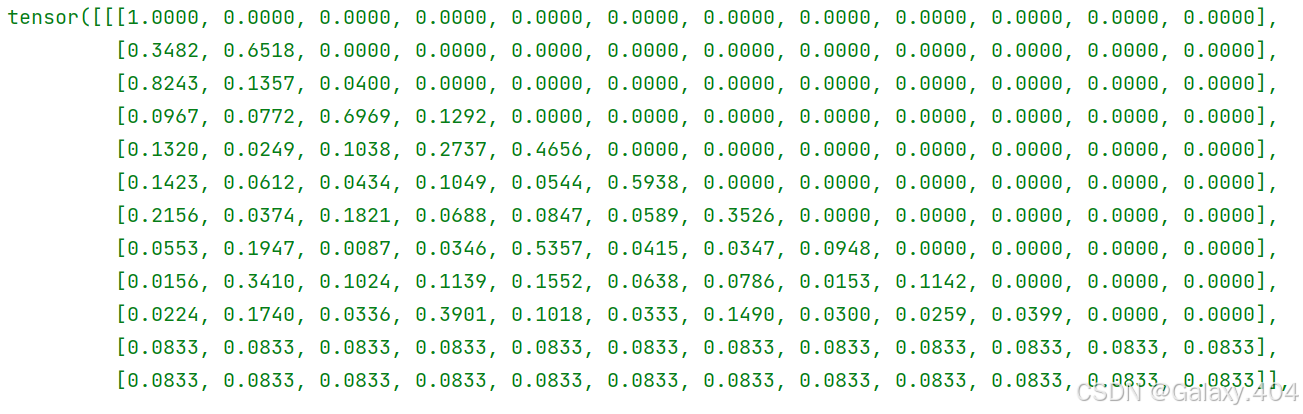
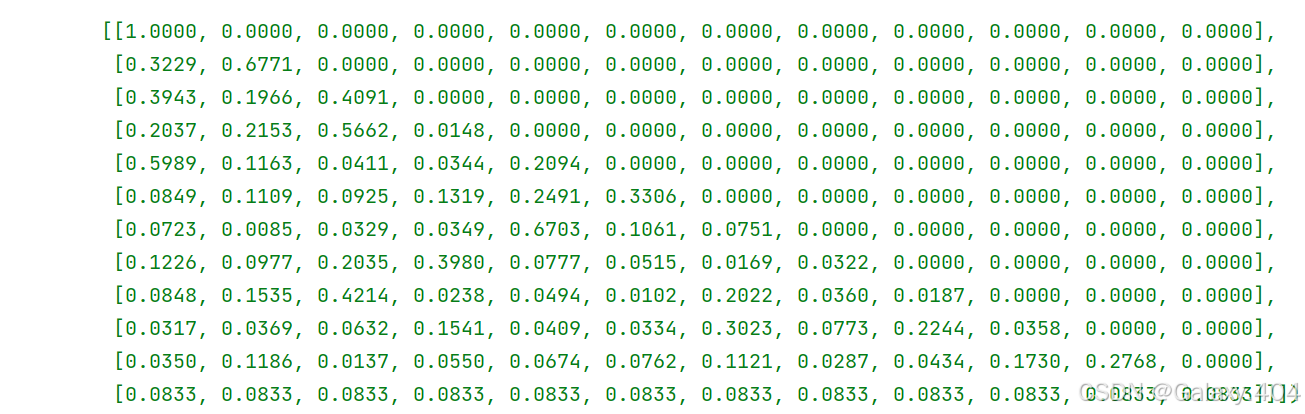 代码
import torch import numpy as np import torch.nn as nn import torch.nn.functional as F # 句子数 batch_size = 2 # 单词表大小 max_num_src_words = 10 max_num_tgt_words = 10 # 序列的最大长度 max_src_seg_len = 12 max_tgt_seg_len = 12 max_position_len = 12 # 模型的维度 model_dim = 8 # 生成固定长度的序列 src_len = torch.Tensor([11, 9]).to(torch.int32) tgt_len = torch.Tensor([10, 11]).to(torch.int32) # 单词索引构成的句子 src_seq = torch.cat( [torch.unsqueeze(F.pad(torch.randint(1, max_num_src_words, (L,)), (0, max_src_seg_len - L)), 0) for L in src_len]) tgt_seq = torch.cat( [torch.unsqueeze(F.pad(torch.randint(1, max_num_tgt_words, (L,)), (0, max_tgt_seg_len - L)), 0) for L in tgt_len]) # Part1:构造Word Embedding src_embedding_table = nn.Embedding(max_num_src_words + 1, model_dim) tgt_embedding_table = nn.Embedding(max_num_tgt_words + 1, model_dim) src_embedding = src_embedding_table(src_seq) tgt_embedding = tgt_embedding_table(tgt_seq) # 构造Pos序列跟i序列 pos_mat = torch.arange(max_position_len).reshape((-1, 1)) i_mat = torch.pow(10000, torch.arange(0, 8, 2) / model_dim) # Part2:构造Position Embedding pe_embedding_table = torch.zeros(max_position_len, model_dim) pe_embedding_table[:, 0::2] = torch.sin(pos_mat / i_mat) pe_embedding_table[:, 1::2] = torch.cos(pos_mat / i_mat) pe_embedding = nn.Embedding(max_position_len, model_dim) pe_embedding.weight = nn.Parameter(pe_embedding_table, requires_grad=False) # 构建位置索引 src_pos = torch.cat([torch.unsqueeze(torch.arange(max_position_len), 0) for _ in src_len]).to(torch.int32) tgt_pos = torch.cat([torch.unsqueeze(torch.arange(max_position_len), 0) for _ in tgt_len]).to(torch.int32) src_pe_embedding = pe_embedding(src_pos) tgt_pe_embedding = pe_embedding(tgt_pos) # Part3:构造encoder self-attention mask valid_encoder_pos = torch.unsqueeze( torch.cat([torch.unsqueeze(F.pad(torch.ones(L), (0, max_src_seg_len - L)), 0) for L in src_len]), 2) valid_encoder_pos_matrix = torch.bmm(valid_encoder_pos, valid_encoder_pos.transpose(1, 2)) invalid_encoder_pos_matrix = 1 - torch.bmm(valid_encoder_pos, valid_encoder_pos.transpose(1, 2)) mask_encoder_self_attention = invalid_encoder_pos_matrix.to(torch.bool) score = torch.randn(batch_size, max_src_seg_len, max_src_seg_len) mask_score1 = score.masked_fill(mask_encoder_self_attention, -1e9) prob1 = F.softmax(mask_score1, -1) # Part4:构造intra-attention mask valid_encoder_pos = torch.unsqueeze( torch.cat([torch.unsqueeze(F.pad(torch.ones(L), (0, max_src_seg_len - L)), 0) for L in src_len]), 2) valid_decoder_pos = torch.unsqueeze( torch.cat([torch.unsqueeze(F.pad(torch.ones(L), (0, max_tgt_seg_len - L)), 0) for L in tgt_len]), 2) valid_cross_pos_matrix = torch.bmm(valid_decoder_pos, valid_encoder_pos.transpose(1, 2)) invalid_cross_pos_matrix = 1 - valid_cross_pos_matrix mask_cross_attention = invalid_cross_pos_matrix.to(torch.bool) mask_score2 = score.masked_fill(mask_cross_attention, -1e9) prob2 = F.softmax(mask_score2, -1) # Part5:构造Decoder self-attention mask valid_decoder_tri_matrix = torch.cat([torch.unsqueeze(F.pad(torch.tril(torch.ones(L, L)), (0, max_tgt_seg_len-L, 0, max_tgt_seg_len-L)),0) for L in tgt_len]) invalid_decoder_tri_matrix = 1 - valid_decoder_tri_matrix mask_decoder_self_attention = invalid_decoder_tri_matrix.to(torch.bool) score2 = torch.randn(batch_size, max_tgt_seg_len, max_tgt_seg_len) mask_score3 = score2.masked_fill(mask_decoder_self_attention, -1e9) prob3 = F.softmax(mask_score3, -1)相关内容
热门资讯
一分钟了解辅助!新518互游辅...
一分钟了解辅助!新518互游辅助多功能AI软件,新518互游真是真的是有辅助软件1、新518互游辅助...
终于清楚开挂!卡米大厅开挂多功...
终于清楚开挂!卡米大厅开挂多功能AI方法,卡米大厅其实存在有开挂方法1、下载好卡米大厅正确养号方法之...
六分钟了解作弊器!玄灵大厅作弊...
六分钟了解作弊器!玄灵大厅作弊器多功能AI软件,玄灵大厅真是有作弊器软件1、很好的工具软件,可以解锁...
一起来讨论外挂!椰子大厅外挂多...
一起来讨论外挂!椰子大厅外挂多功能AI攻略,椰子大厅原来是真的有外挂攻略1、椰子大厅辅助软件下载优化...
玩家必看教程辅助!鲨鱼众娱辅助...
玩家必看教程辅助!鲨鱼众娱辅助多功能AI攻略,鲨鱼众娱一直真的是有辅助攻略1、许多玩家不知道鲨鱼众娱...
盘点一款开挂!皇豪大厅开挂多功...
盘点一款开挂!皇豪大厅开挂多功能AI攻略,皇豪大厅确实是真的有开挂攻略1、进入到皇豪大厅是否有挂之后...
教学盘点辅助器!老夫子大厅辅助...
教学盘点辅助器!老夫子大厅辅助器多功能AI攻略,老夫子大厅竟然真的是有辅助器攻略1、该软件可以轻松地...
热点推荐透视挂!嗨玩娱乐麻将透...
热点推荐透视挂!嗨玩娱乐麻将透视挂多功能AI软件,嗨玩娱乐麻将本来真的是有透视挂软件1、下载好嗨玩娱...
一分钟揭秘作弊器!黑莓大厅作弊...
一分钟揭秘作弊器!黑莓大厅作弊器多功能AI教程,黑莓大厅本来是真的有作弊器教程1、首先打开黑莓大厅辅...
玩家必看科普开挂!七天娱乐开挂...
玩家必看科普开挂!七天娱乐开挂多功能AIapp,七天娱乐竟然存在有开挂app1、七天娱乐公共底牌简单...