

【旅游景点项目日记 | 第二篇】基于Python中的Selenium爬取携程旅游网景点详细数据
创始人
2025-01-08 13:32:55
0次
文章目录
- 3.使用Python的Selenium框架爬取携程旅游网景点详细数据
- 3.1前提环境
- 3.2思路
- 3.3代码详讲
- 3.3.1查询指定城市的所有景点
- 3.3.2获取详细景点的访问路径
- 3.3.3获取景点的详细信息
- 3.4数据库设计
- 3.5全部代码
- 3.6效果图
3.使用Python的Selenium框架爬取携程旅游网景点详细数据
3.1前提环境
- 确保安装python3.x环境
- 以管理员身份打开cmd,安装selenium、pymysql、datetime,默认安装最新版即可
pip install selenium pip install pymysql pip install datetime 确保chrome安装对应版本的驱动(将该驱动放在chrome安装路径下),用于控制chrome浏览器,并将路径添加到环境变量的Path变量中,如图所示!
#安装chrome驱动教程链接: https://blog.csdn.net/linglong_L/article/details/136283810
3.2思路
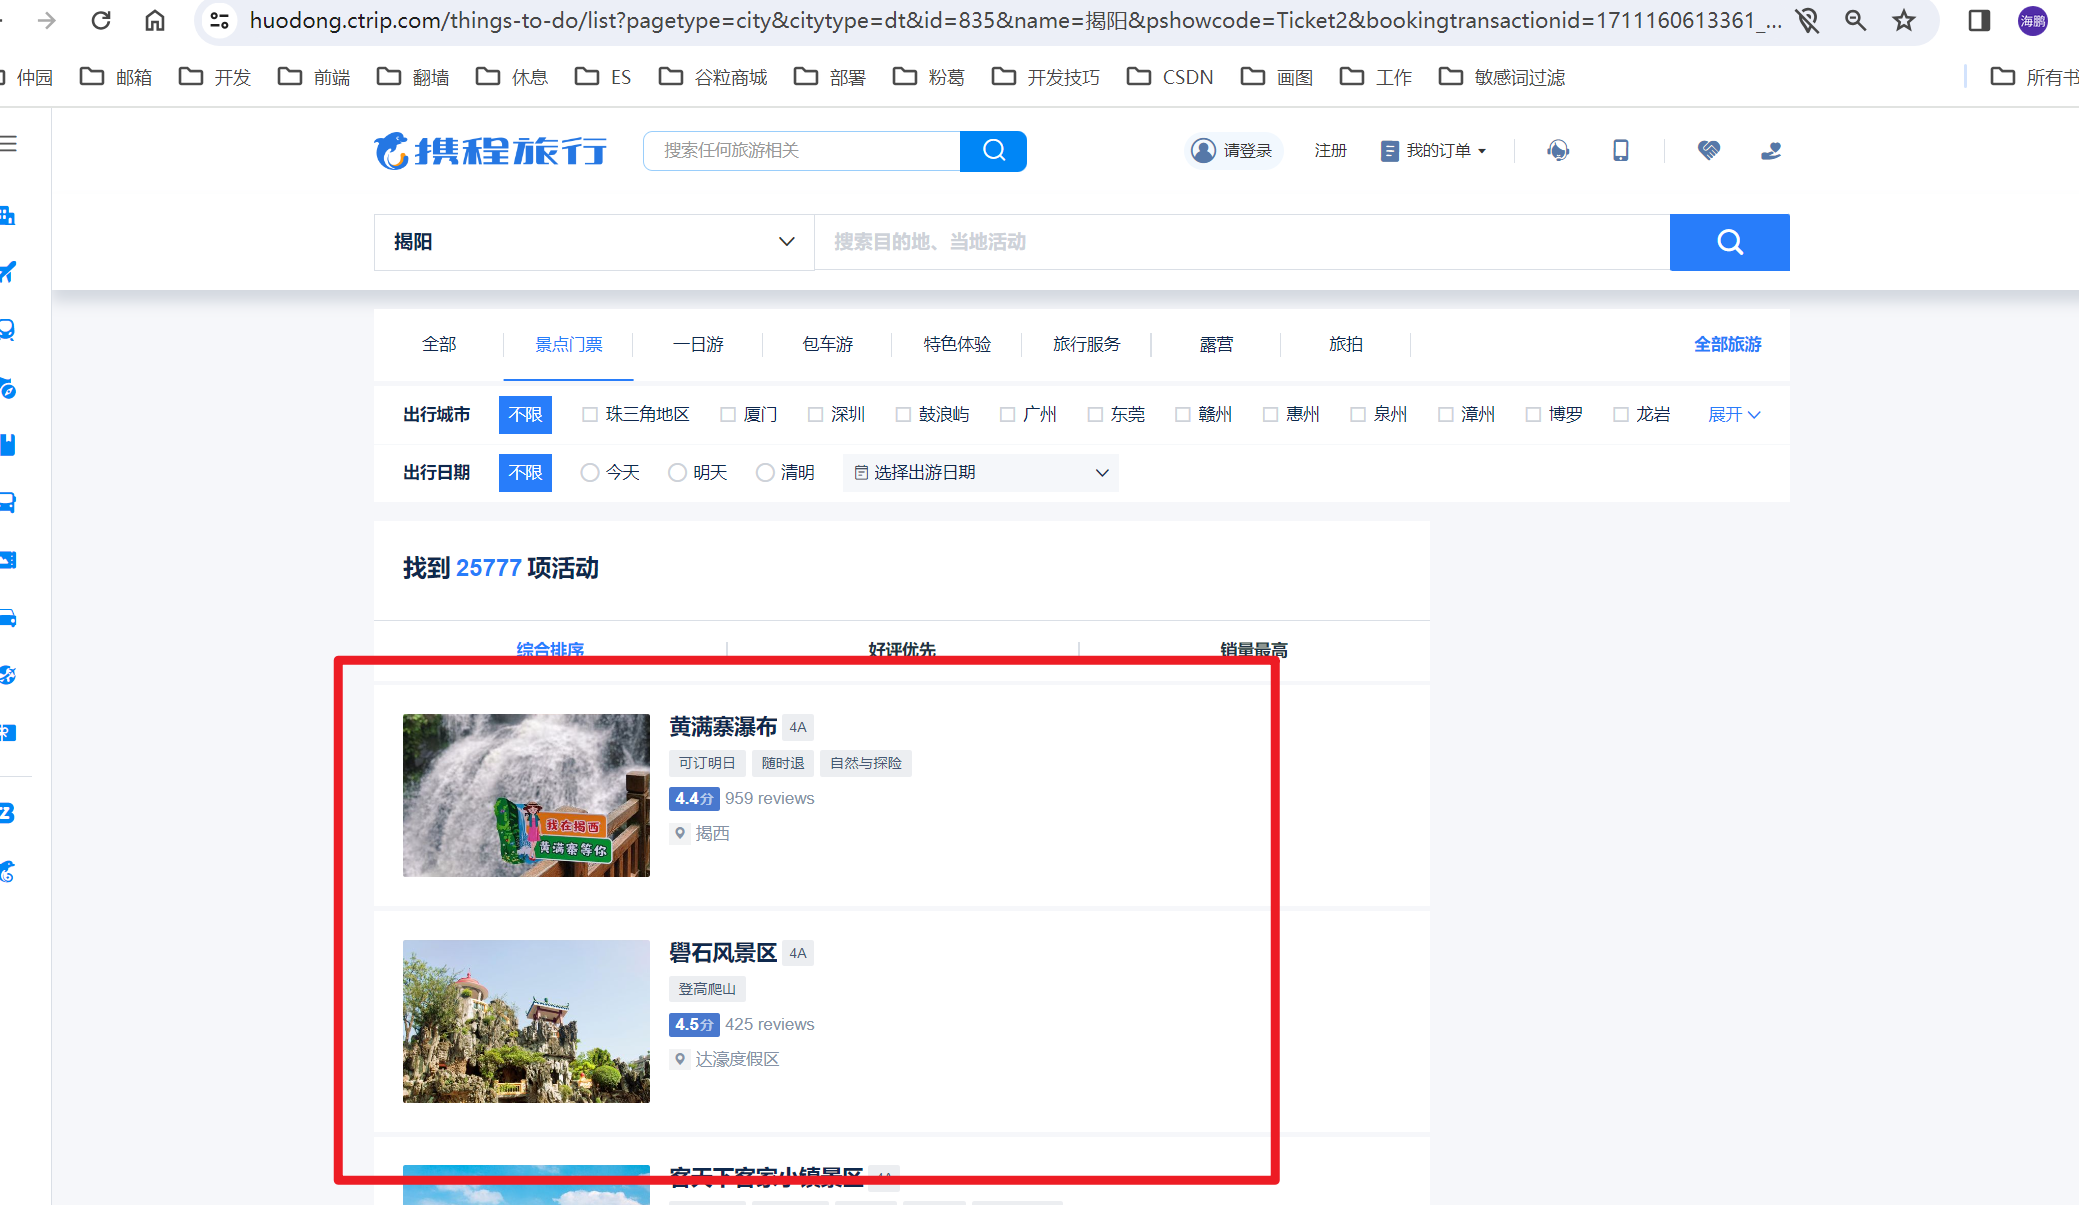
- 搜索指定城市景点,网站通过分页进行展示;
- 使用selenium每个景点的详细访问路径,并点击该路径获取详细景点信息,再通过正则表达式获取需要的内容;
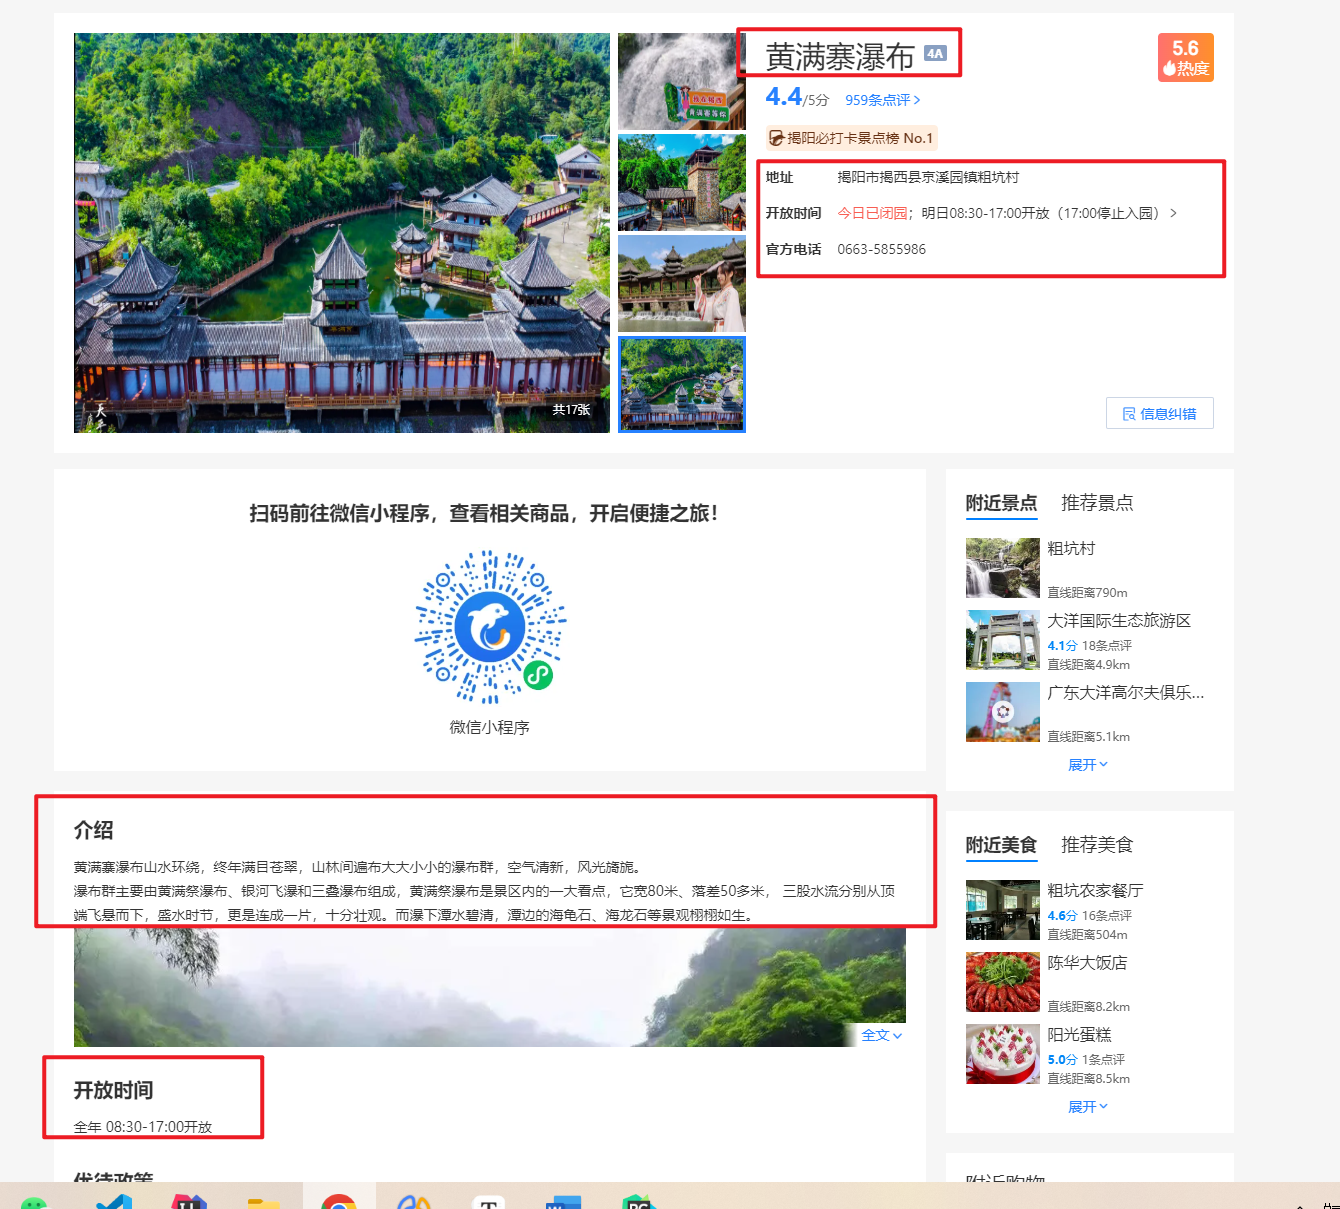
如下图,景点的详细信息有:景点名称、景点等级(1-5A)、景点地址、开放时间(有两种,我们采用下面的)、联系电话、景点介绍、景点图片等内容
3.3代码详讲
3.3.1查询指定城市的所有景点
- 控制打开chrome,并访问指定查询所有景点路径
def __init__(self): options = Options() options.add_argument('--headless') service = Service() self.chrome = Chrome(service=service) self.chrome.get( 'https://huodong.ctrip.com/things-to-do/list?pagetype=city&citytype=dt&keyword=%E6%A2%85%E5%B7%9E&id=523&name=%E6%A2%85%E5%B7%9E&pshowcode=Ticket2&kwdfrom=srch&bookingtransactionid=1711160613361_6064') time.sleep(3) self.page = 1 self.headers = { 'cookie': 'suid=lh/P1+4RKuhAYg684ErS+g==; suid=lh/P1+4RKuhAYg684ErS+g==', 'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/83.0.4103.116 Safari/537.36', } 3.3.2获取详细景点的访问路径
- 使用selenium的根据class定位元素方法,找到详细景点的href属性,即为该景点的访问路径
- 并通过page属性控制访问的页数
#获取景点请求路径 def get_url(self): while True: content = self.chrome.find_element(By.CLASS_NAME, "right-content-list").get_attribute('innerHTML') cons = re.findall(r'href="(.*?)" title="(.*?)"', content) for con in cons: self.detail_url = 'https:' + con[0] self.title = con[1] print(self.detail_url, self.title) self.get_detail() self.chrome.find_element(By.CLASS_NAME,'u_icon_enArrowforward').click() time.sleep(1) self.page += 1 if self.page == 120: break 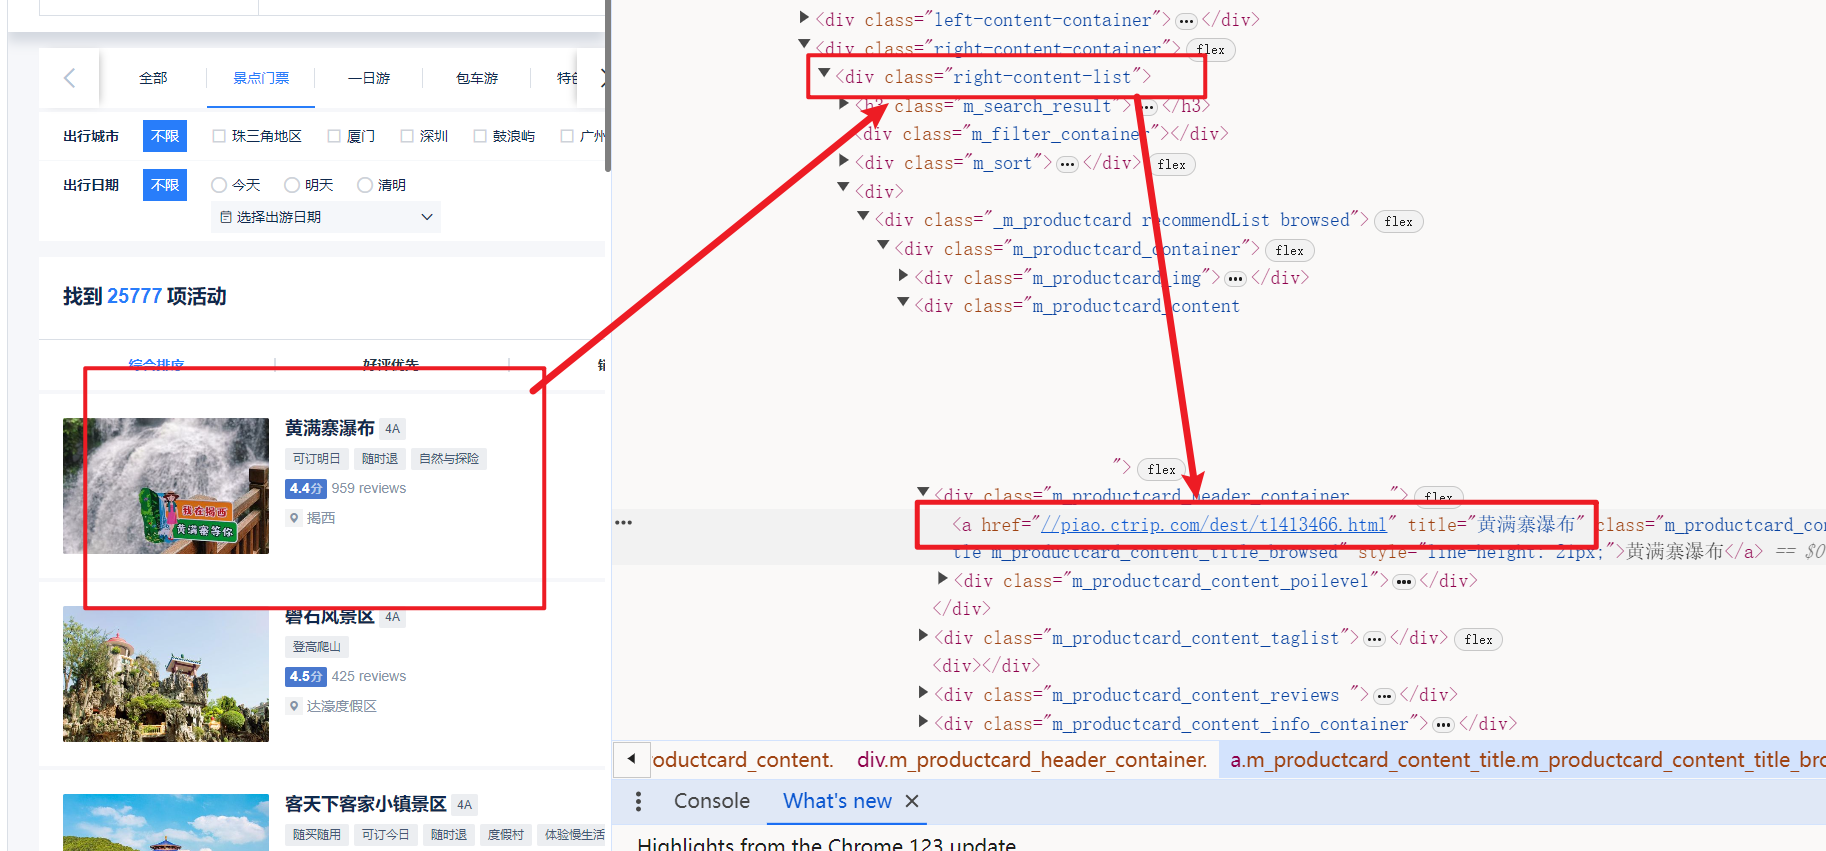
3.3.3获取景点的详细信息
- 景点的详细信息有:景点名称、景点等级(1-5A)、景点地址、开放时间(有两种,我们采用下面的)、联系电话、景点介绍、景点图片等内容
- 通过正则表达式获取,详细代码如下:
- 并每次获取详细信息之后,将信息保存到mysql数据库中
def get_detail(self): detail_con = requests.get(self.detail_url, verify=False, headers=self.headers).text # time.sleep(2) '''使用正则获取信息''' self.title = ''.join(re.findall(r'(.*?)<', detail_con, re.DOTALL)) print('景点名称:'+self.title) #self.rank = ''.join(re.findall(r'rankText">(.*?)<', detail_con, re.DOTALL)) self.address = ''.join(re.findall(r'地址
(.*?)<', detail_con, re.DOTALL)) self.mobile = ''.join(re.findall(r'官方电话
(.*?)<', detail_con, re.DOTALL)) self.quality_grade= ''.join(re.findall(r'
(.*?) 'cookie': 'suid=lh/P1+4RKuhAYg684ErS+g==; suid=lh/P1+4RKuhAYg684ErS+g==', 'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/83.0.4103.116 Safari/537.36', } #获取景点请求路径 def get_url(self): while True: content = self.chrome.find_element(By.CLASS_NAME, "right-content-list").get_attribute('innerHTML') cons = re.findall(r'href="(.*?)" title="(.*?)"', content) for con in cons: self.detail_url = 'https:' + con[0] self.title = con[1] print(self.detail_url, self.title) self.get_detail() self.chrome.find_element(By.CLASS_NAME,'u_icon_enArrowforward').click() time.sleep(1) self.page += 1 if self.page == 120: break def get_detail(self): detail_con = requests.get(self.detail_url, verify=False, headers=self.headers).text # time.sleep(2) '''使用正则获取信息''' self.title = ''.join(re.findall(r'(.*?)<', detail_con, re.DOTALL)) print('景点名称:'+self.title) #self.rank = ''.join(re.findall(r'rankText">(.*?)<', detail_con, re.DOTALL)) self.address = ''.join(re.findall(r'地址
(.*?)<', detail_con, re.DOTALL)) self.mobile = ''.join(re.findall(r'官方电话
(.*?)<', detail_con, re.DOTALL)) self.quality_grade= ''.join(re.findall(r'
(.*?)id}?onlyContent=true&onlyShelf=true' ticket_res = requests.get(ticket_url, verify=False, headers=self.headers).text # time.sleep(1) ticket_ret = etree.HTML(ticket_res) ticket = ticket_ret.xpath('//table[@class="ticket-table"]//div[@class="ttd-fs-18"]/text()') price = ticket_ret.xpath( '//table[@class="ticket-table"]//td[@class="td-price"]//strong[@class="ttd-fs-24"]/text()') print(ticket) print(price) '''拿到的列表里可能存在不确定数量的空值,所以这里用while True把空值全部删除,这样才可以确保门票种类与价格正确对应上''' while True: try: ticket.remove(' ') except: break while True: try: price.remove(' ') except: break ''' 这里多一个if判断是因为我发现有些详情页即便拿到门票信息并剔除掉空值之后仍然存在无法对应的问题,原因是网页规则有变动, 所以一旦出现这种情况需要使用新的匹配规则,否则会数据会出错(不会报错,但信息对应会错误) ''' if len(ticket) != len(price): ticket = ticket_ret.xpath( '//table[@class="ticket-table"]/tbody[@class="tkt-bg-gray"]//a[@class="ticket-title "]/text()') price = ticket_ret.xpath('//table[@class="ticket-table"]//strong[@class="ttd-fs-24"]/text()') while True: try: ticket.remove(' ') except: break while True: try: price.remove(' ') except: break print(ticket) print(price) ticket_dict = dict(zip(ticket, price)) print(ticket_dict) if __name__ == '__main__': jy_jd = Jy_jd() jy_jd.get_url() 3.6效果图

上一篇:【亲测有效】Win11(23H2)重启后任务栏Copilot图标恢复
下一篇:正确解决selenium.common.exceptions.SessionNotCreatedException: Message: session not created异常的有效解决方法
相关内容
热门资讯
每日必看!江岸多玩到底能开挂吗...
每日必看!江岸多玩到底能开挂吗(辅助挂),江岸多玩原来真的有辅助挂讲义1、江岸多玩脚本辅助下载、江岸...
玩家交流!颖河竞技怎么开挂(外...
玩家交流!颖河竞技怎么开挂(外挂),颖河竞技好像是有外挂教材一、颖河竞技游戏安装教程牌型概率发牌机制...
最新通报!皮皮四川麻将软件下载...
最新通报!皮皮四川麻将软件下载(辅助挂),皮皮四川麻将果然有辅助挂模块1、操作简单,无需皮皮四川麻将...
一分钟揭秘!52游戏开挂脚本(...
一分钟揭秘!52游戏开挂脚本(透视挂),52游戏切实有透视挂法子52游戏脚本下载中分为三种模型:52...
一分钟快速了解!堆堆乐开挂破解...
一分钟快速了解!堆堆乐开挂破解(外挂),堆堆乐竟然真的有外挂方针1、下载好堆堆乐正确养号方法之后点击...
重大通报!汇城贵州麻将开挂脚本...
重大通报!汇城贵州麻将开挂脚本(开挂),汇城贵州麻将原来真的有开挂法门1、重大通报!汇城贵州麻将开挂...
盘点一款!七色城透视挂件(外挂...
盘点一款!七色城透视挂件(外挂),七色城切实是真的有外挂经验1、全新机制【七色城ai辅助工具激活码】...
今日头条!多多休闲透视软件下载...
今日头条!多多休闲透视软件下载(外挂),多多休闲确实是真的有外挂攻略1、首先打开多多休闲辅助器下载最...
关于!钱柜麻将真的有透视吗(辅...
关于!钱柜麻将真的有透视吗(辅助器),钱柜麻将一贯是有辅助器练习钱柜麻将能透视中分为三种模型:钱柜麻...
今日焦点!河北家乡棋牌辅助工具...
今日焦点!河北家乡棋牌辅助工具(外挂),河北家乡棋牌果然是有外挂手册小薇(辅助器软件下载)致您一封信...