
Spark RDD实现分组求TopN
Spark RDD实现分组求TopN
- 项目需求
- 实现思路
- 实现代码
- 导入数据
- Scala代码
- 代码分析
- 运行结果
项目需求
有以下学生成绩数据:
Andy,98
Jack,87
Bill,99
Andy,78
Jack,85
Bill,86
Andy,90
Jack,88
Bill,76
Andy,58
Jack,67
Bill,79
同一个学生有多门成绩,现需要计算每个学生分数最高的前3个成绩,期望的输出结果如下:
姓名:Andy
成绩:98
成绩:90
成绩:78
*******************
姓名:Bill
成绩:99
成绩:86
成绩:79
*******************
姓名:Jack
成绩:88
成绩:87
成绩:85
*******************
实现思路
因为每一行为一条数据,所以先构成(姓名,成绩)二元组,然后根据姓名进行分组,对组内数据按照降序排列,取前3个,最后按照输出语句打印结果。
实现代码
导入数据
创建data文件夹,将数据sc.txt上传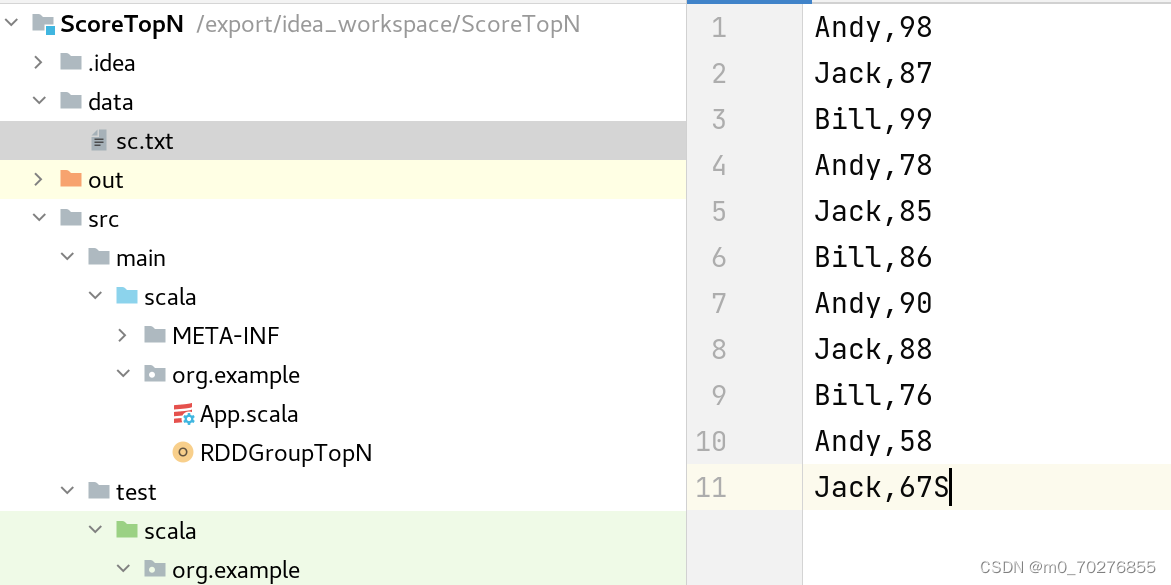
Scala代码
package org.example import org.apache.spark.{SparkConf, SparkContext} import org.apache.spark.rdd.RDD object RDDGroupTopN { def main(args: Array[String]): Unit = { // 环境准备 val sparkConf = new SparkConf().setMaster("local[*]").setAppName("TopN") val sc = new SparkContext(sparkConf) // 读取数据 val rdd: RDD[String] = sc.textFile("data/sc.txt") rdd .map(line => { val fields = line.split(",") //每一行按照,进行切分 (fields(0), fields(1)) //返回(姓名,成绩)二元组 }) .groupBy(_._1) //根据姓名进行分组,(Andy,CompactBuffer((Andy,98), (Andy,78), (Andy,90), (Andy,58))) .mapValues(x => { //((Andy,98), (Andy,78), (Andy,90), (Andy,58)) x.map(_._2).toList.sortWith(_ > _).take(3) //根据值进行排序,取前三个 }) .collect().foreach( //打印成绩 x => { println("姓名:" + x._1) x._2.foreach(y => { println("成绩:" + y) }) println("********************") }) } } 代码分析
该Scala代码使用了Apache Spark的RDD(弹性分布式数据集)API来处理一个文本文件,该文件包含按逗号分隔的姓名和成绩数据。
环境准备:
创建一个SparkConf对象,并设置Spark集群的master URL为local[*](表示在本地模式下使用所有可用的核心)以及应用名称为"TopN"。
使用SparkConf对象创建一个SparkContext对象,这是Spark功能的入口点。读取数据:
使用SparkContext的textFile方法读取名为"data/sc.txt"的文本文件,并返回一个包含文件所有行的RDD。数据转换:
使用map操作转换RDD中的每一行。每一行被分割成多个字段(基于逗号),然后返回一个包含姓名和成绩的二元组((String, String))。
使用groupBy操作根据姓名(二元组的第一个元素)对数据进行分组。这会得到一个新的RDD,其中的元素是二元组,其中第一个元素是姓名,第二个元素是一个迭代器,包含与该姓名关联的所有成绩的二元组。
接着,对分组后的RDD使用mapValues操作。对于每个姓名,它将其关联的成绩列表(从迭代器转换为列表)按降序排序,并取前三个成绩。
sortWith(_ > _)用于降序排序。如果成绩是字符串形式的数字(例如"98","78"等),则需要确保它们是正确的数字格式以便进行准确的比较。
- 结果收集与打印:
使用collect操作将结果RDD从集群中拉取到驱动程序中,这会返回一个Scala数组,包含所有分组后的姓名和成绩列表。
使用foreach操作遍历这个数组,并打印每个姓名及其对应的三个最高成绩。每个姓名和成绩列表之间用"********************"分隔。
注意:由于使用了collect操作,这意味着所有处理后的数据都会被拉取到驱动程序中。对于大数据集,这可能会导致驱动程序内存不足。如果仅需要处理部分结果(例如,仅查看最高分的几个学生),可以考虑使用take或其他方法而不是collect。
运行结果
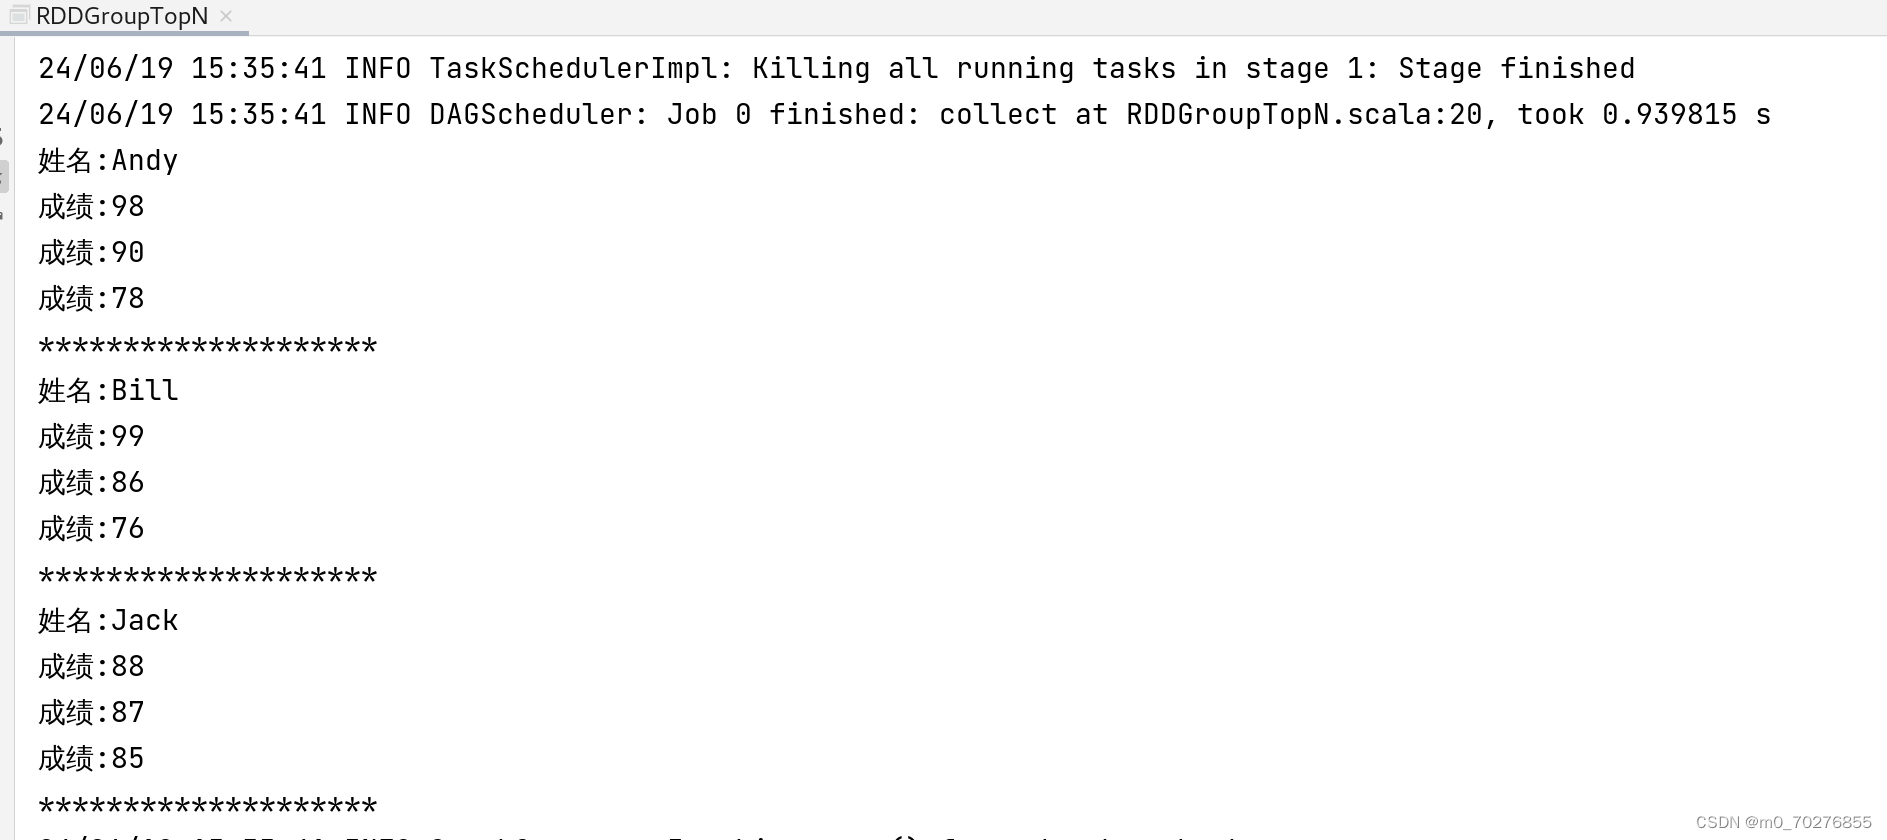
运行结果与期望输出结果一致